// TÉMA
Lokální AI modely
Lokální AI modely běží na vlastním hardwaru, takže data nemusí být odesílána do externí služby.
01 / Články
Qwen na Intel Arc: co znamená 17 tokenů/s na notebooku s 96 GB RAM
Praktický rozbor běhu Qwen3.6 35B a Qwen3-Coder-Next 80B přes Ollama a Vulkan na Intel Arc. Vysvětluje, co znamená „100 % GPU“, proč paměť rozhoduje o výkonu a kdy už iGPU nestačí.
Ollama
AI hudební videoklip na Radeonu: plánování, generování a střih
Návod pro rozdělení písně na scény, výběr mezi lokálním a cloudovým generováním i finální střih čtyřminutového hudebního videoklipu na Radeonu.
Claude CodeClaude OpusCodexCodex CLI+3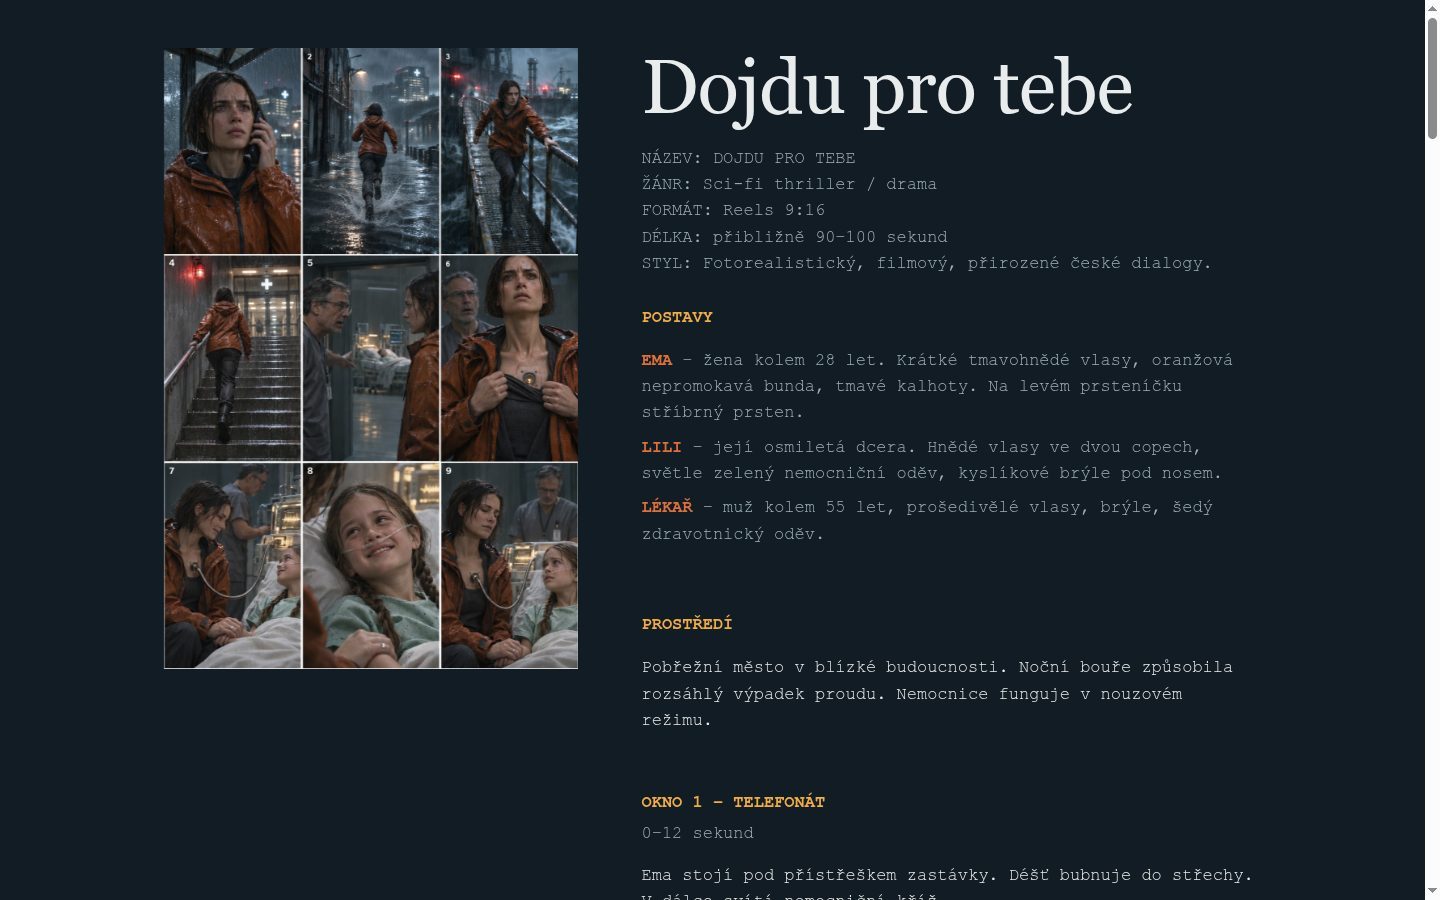
Video ze scénáře v ComfyUI: záběry, dialogy, střih a zvuk
Lokální pipeline v ComfyUI rozdělí scénář na záběry, naváže klipy přes latent a spojí obraz, řeč, hudbu i efekty. Podívejte se na postup i nejčastější chyby.
Claude OpusComfyUIHiggs AudioMiniMax+1
Lokální AI agent na notebooku: oddělte model od agenta a skriptů
Jak na notebooku s 8 GB VRAM oddělit model, agenta, vyhledávání a spouštění skriptů, aby citlivá data zůstala lokálně a workflow bylo bezpečnější.
ClineGPT-OSS 20BLM StudioNVIDIA Nemotron 3.5 Bolt E4B+1
Pipeline podle rizika: cloud, lokální AI a citlivé dokumenty
Jak rozdělit firemní dokumenty podle rizika a vybrat mezi regionálním cloudem, lokální inferencí, pseudonymizací a děleným workflow. Samotné regionální uložení nezaručuje zpracování pouze v EU.
Amazon BedrockAzure OpenAIGitHub CopilotGoogle Vertex AI+1
Kimi K3.1 Pro: co přináší a kde narazí na vlastní infrastrukturu
Kimi K3.1 Pro přináší milionový kontext, vizuální vstup a agentní nástroje pro hry i 3D. Zároveň ukazuje, proč je „lokální běh“ na vlastní infrastruktuře obtížně dostupný a jak vyhodnotit jeho reálné přínosy.
KimiKimi K3.1 Pro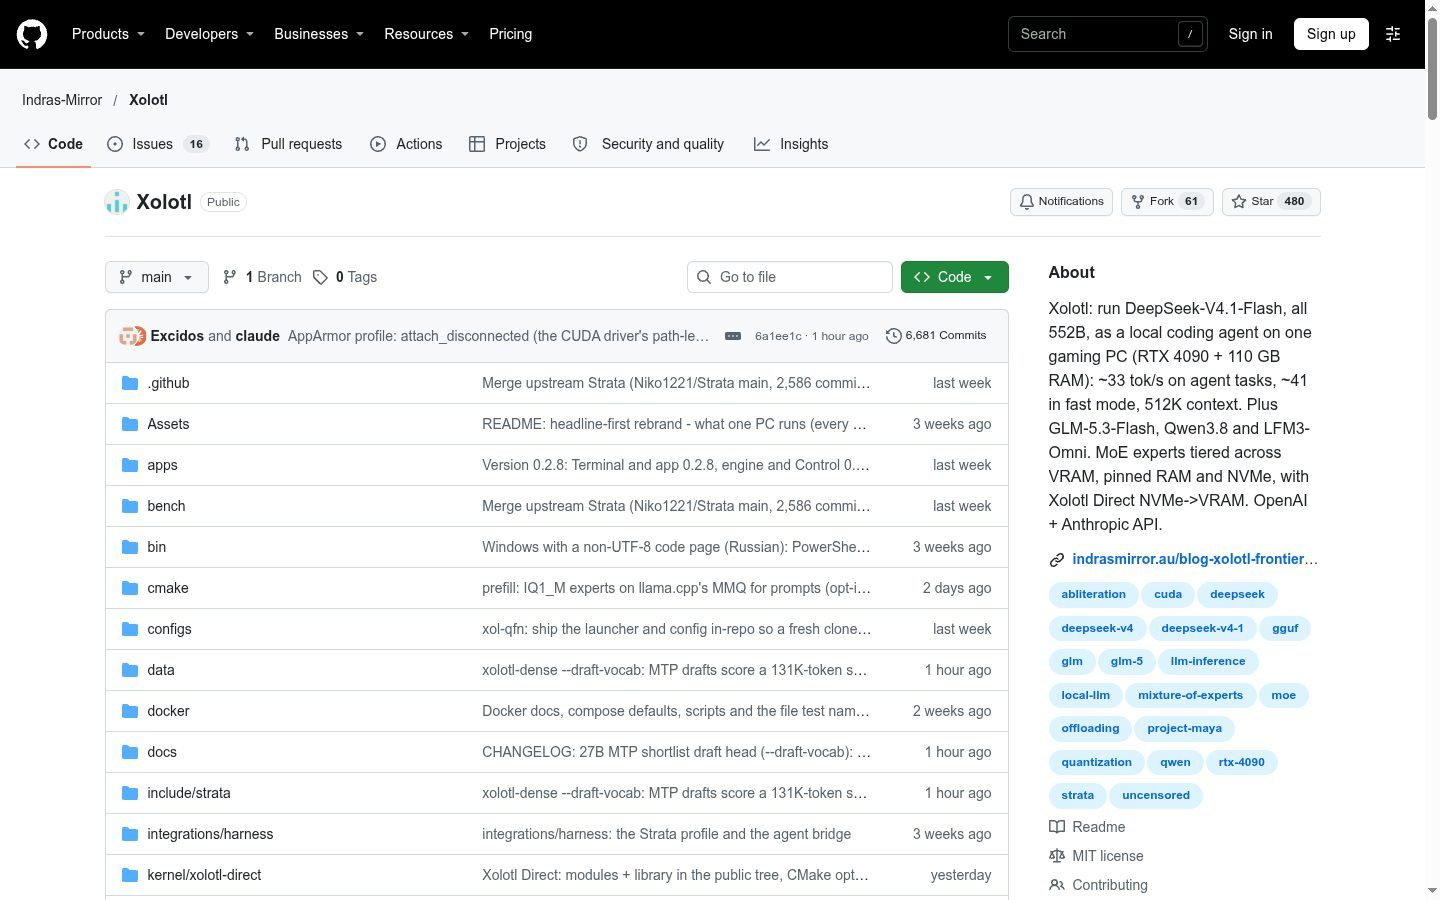
Server pro lokální LLM: RAM, GPU a backend podle skutečné zátěže
Jak z kapacity modelu a kontextu vypočítat potřebu serveru, kdy pomůže ECC RAM a dual-socket a kdy zvolit llama.cpp, vLLM nebo menší sestavu.
llama.cppvLLM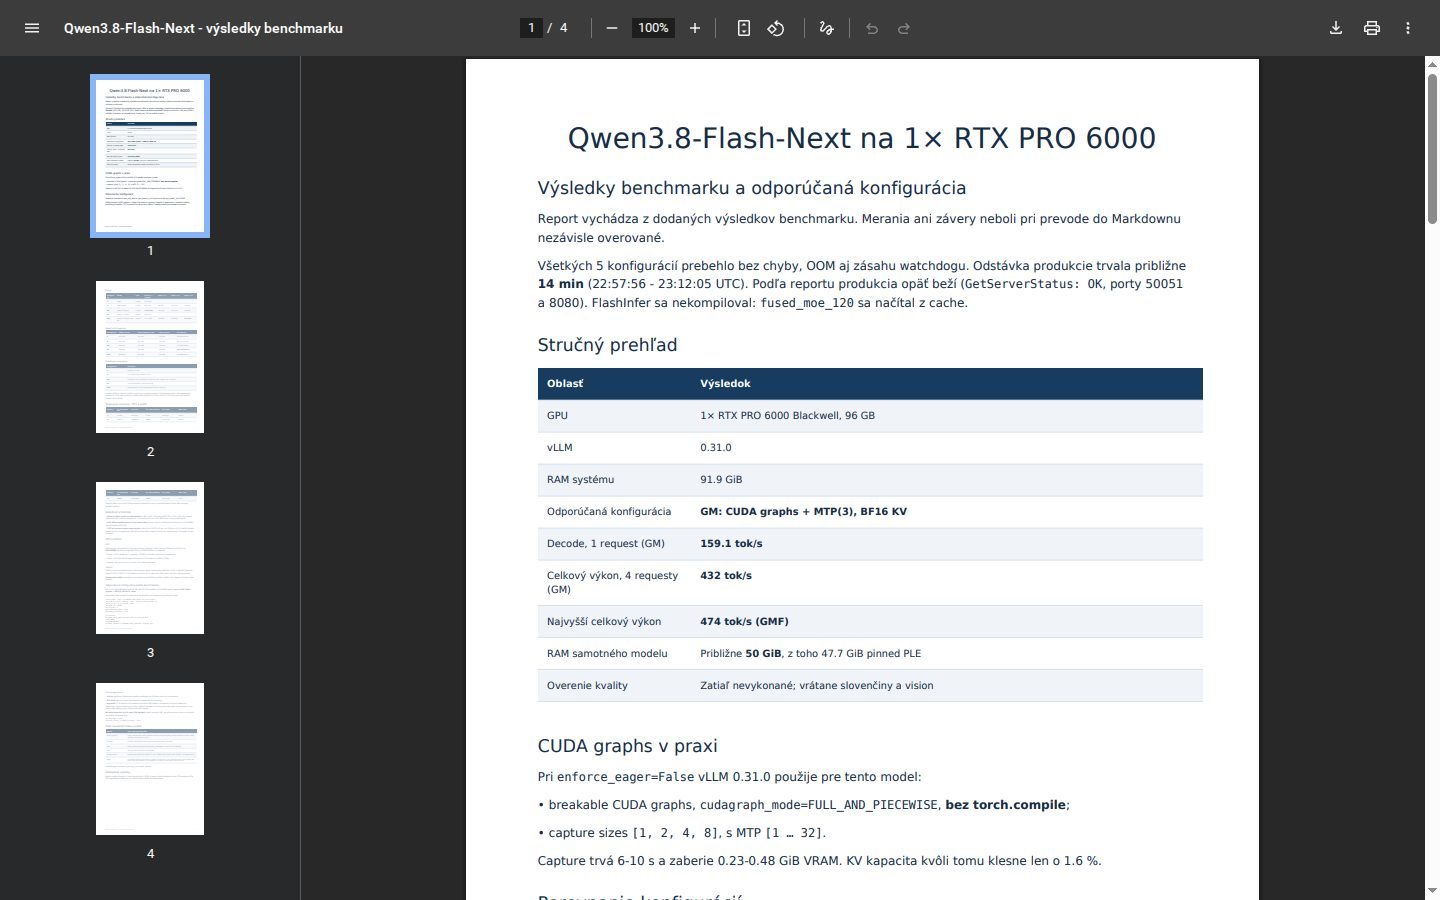
Qwen3.8 na lokálních GPU: rychlost, paměť a vlastní benchmark
Jak porovnat Qwen3.8 Flash Next a 27B na RTX PRO 6000 či RTX 3090? Návod k měření propustnosti, TTFT, VRAM/RAM a kvality bez zavádějícího porovnání.
Qwen 3.8 27BQwen 3.8 Flash NextStrata enginevLLM