⚡ 73,3k tokenů · 5 modelů · Výpočetní stopa ▾
Které AI modely se na článku podílely a kolik tokenů spotřebovaly (vstup / výstup).
| Model | Role | Kde běží | Vstup | Výstup | Volání |
|---|---|---|---|---|---|
| MiniMax | návrh článku | cloud | 13,7k | 2,3k | 1 |
| MiniMax | plánování námětu | cloud | 9,9k | 701 | 1 |
| MiniMax | faktová oprava | cloud | 7,1k | 3,4k | 1 |
| MiniMax | zpracování rešerše | cloud | 5,2k | 2,1k | 2 |
| MiniMax | ověření faktů | cloud | 5,9k | 647 | 2 |
| MiniMax | stylistika | cloud | 3,0k | 3,0k | 1 |
| Qwen 35B | audit přínosu | lokálně | 2,5k | 2,1k | 1 |
| Gemma Vision | kontrola screenshotů | lokálně | 2,9k | 300 | 2 |
| gemini-flash (Antigravity) | jazyková korektura | cloud | 1,6k | 1,5k | 1 ~ |
| MiniMax | hodnocení přínosu | cloud | 2,9k | 142 | 1 |
| perplexity (Grok 4.7) | audit přínosu | cloud | 248 | 1,5k | 1 ~ |
| perplexity (Grok 4.7) | ověření faktů | cloud | 143 | 727 | 1 ~ |
~ odhad: Perplexity a korektura Gemini běží mimo naši bránu, tokeny se odhadují z délky textu.
Server pro lokální LLM: RAM, GPU a backend podle skutečné zátěže
Jak z kapacity modelu a kontextu vypočítat potřebu serveru, kdy pomůže ECC RAM a dual-socket a kdy zvolit llama.cpp, vLLM nebo menší sestavu.
Nejdřív pracovní zátěž, ne počet komponent
Server pro lokální LLM se neplánuje podle největšího modelu, který lze „někde spustit“. Rozhodující je, zda potřebujete rychlou odpověď jednomu uživateli, nebo chcete zpracovat frontu dokumentů.
Komunita popsala dvojprocesorový server s 512 GB ECC RAM a dvojicí 24GB grafik. Zvolený hardware měl především umožnit hybridní běh: expertní bloky modelu zůstávaly v RAM, zatímco attention a KV cache byly na GPU. Pro dávkovou textovou analýzu byla rychlost méně důležitá než kvalita výsledku. Menší modely přitom zvládaly interaktivní práci.
Toto rozlišení je zásadní. Přesnou kapacitu určují tři samostatné položky:
- Váhy modelu podle kvantizace a počtu parametrů.
- KV cache pro současně zpracované kontexty.
- Propustnost a umístění paměti, protože při přenosu mezi RAM a GPU může vzniknout úzké hrdlo.
Kapacitu lze orientačně odhadnout jako parametry × bajty na parametr. Přesnější je použít konfiguraci modelu, zejména počet vrstev, KV hlaviček, head_dim a délku kontextu. Velikost KV cache proto nelze spolehlivě odvodit z jediného pravidla bez znalosti konkrétní architektury modelu.
Kdy potřebujete opravdu velký server
Malá sestava stačí, pokud se váhy i KV cache jednoho pracovního kontextu vejdou do rychlé paměti. Samotných 512 GB RAM a dvě 24GB karty ale nejsou důkazem, že takový server bude rychlý. Důležité je, kde právě běží aktivní část modelu.
Supermicro H12DSi-NT6 podporuje dva procesory AMD EPYC, 16 slotů DIMM a osmikanálovou paměť. Dvojprocesorová konfigurace tedy může poskytnout vyšší agregovanou propustnost než jednosocketová deska se stejnou celkovou kapacitou. Podle autora byl rozdíl patrný právě při hybridním přenosu expertů mezi RAM a GPU.
Serverová základní deska Supermicro H12DSi-NT6 podporuje dvojici procesorů EPYC, osmikanálovou paměť a kapacitu až 4 TB Registered ECC DDR4 v 16slotové konfiguraci s 256GB moduly.
ECC RAM zde není jen označením „serverové sestavy“. Ochrana proti bitovým chybám je důležitá při dlouhém běhu, ale sama o sobě neurychluje generování. Ani druhý socket automaticky nezdvojnásobí výkon. Při dekódování tokenu se totiž čte téměř celá váha každé vrstvy; úzkým hrdlem je přístup k paměti, nikoli počet jader.
Druhý procesor proto pomáhá především tam, kde je užitečné rozdělit práci na více nezávislých úloh nebo instancí. Jedna instance přes oba NUMA uzly nemusí využít výhodu dvou socketů. Vzdálený přístup k NUMA paměti navíc stojí propustnost.
Jak to funguje pod kapotou a kde má postup limity
Generování dalšího tokenu je do značné míry memory-bound: systém opakovaně načítá váhy modelu z paměti. TFLOPS proto nejsou jediným kritériem. Rozhoduje kapacita, latence a propustnost paměti, v níž jsou váhy umístěny.
Dvojice GPU může výkon zvýšit třemi způsoby: rozdělením vrstev přes pipeline parallel, rozdělením matice přes tensor parallel nebo nezávislým zpracováním požadavků. Bez vhodného paralelismu dvě karty rychlost jednoho streamu téměř nezdvojnásobí. PCIe navíc může omezit přenos mezi VRAM a hostovskou RAM.
Prefill dlouhého promptu je výpočtově náročnější a na více procesorech škáluje lépe než samotné generování. Při dekódování je rozhodující čtení vah. Tento rozdíl je důležitý pro plánování: server může rychle přijmout a zpracovat dlouhý vstup, ale jednotlivé odpovědi budou pomalejší.
Hybridní attention může KV cache zmenšit oproti jednoduchému odhadu. GQA, MLA nebo sliding window mění její velikost; počet parametrů modelu sám o sobě cache neurčuje. Proto je třeba oddělit rozpočet vah od rozpočtu kontextu.
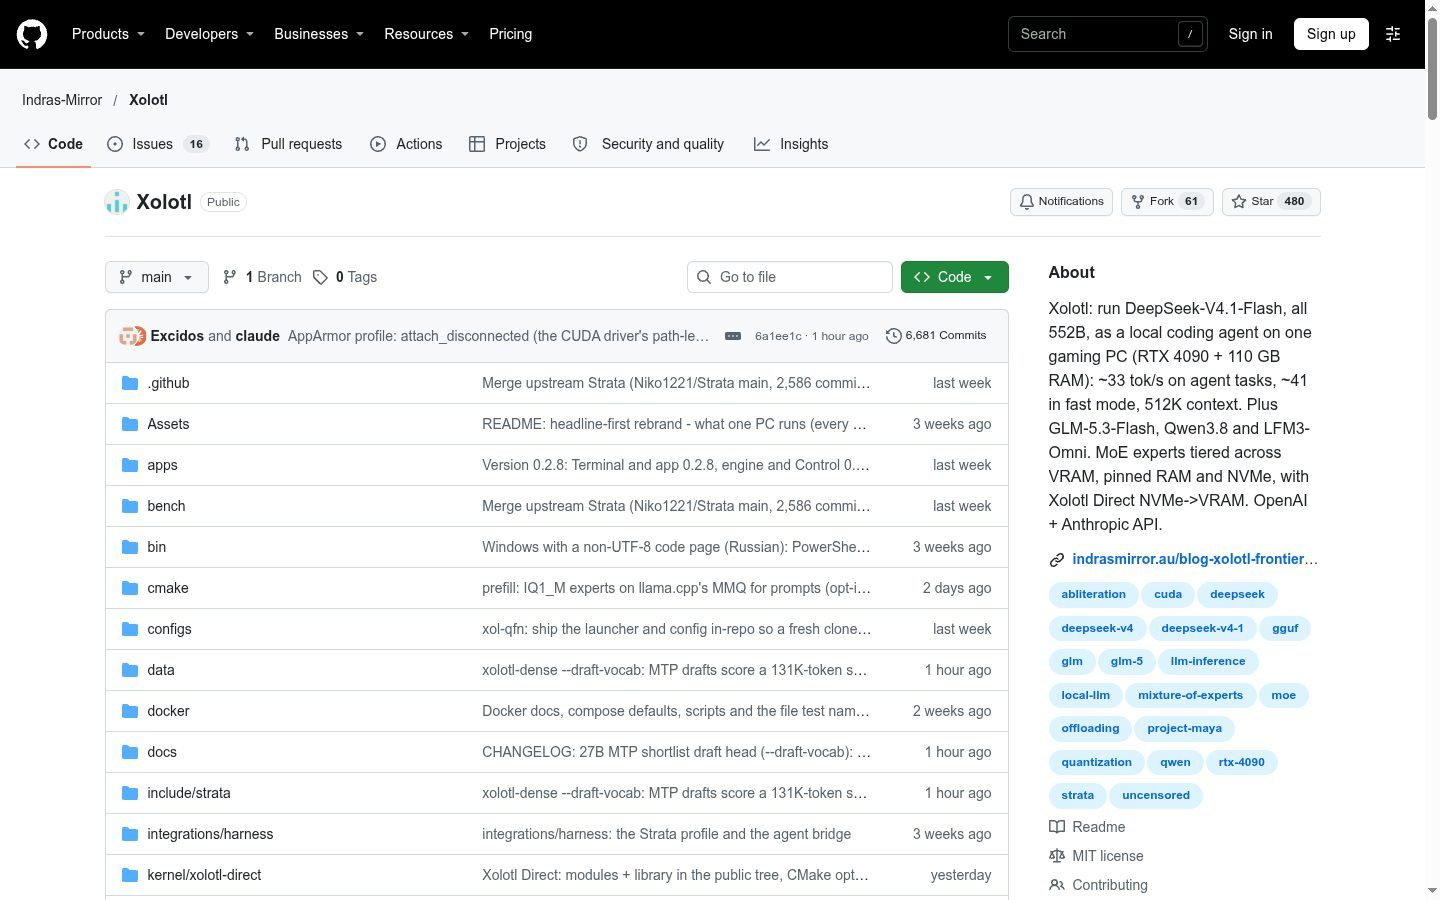
Pro představu o dostupných vrstvách provozu lze vedle běžných runtime zmínit také open-source platformu Xolotl. Ta vznikla rozšířením projektu Strata, nabízí API kompatibilní s OpenAI a Anthropic, vrstvení expertů mezi VRAM, RAM a NVMe a experimentální funkci Xolotl Direct pro přenos expertních bloků z NVMe přímo do VRAM na Linuxu a NVIDIA. Uváděné rychlosti jsou výsledky autorů projektu, nikoli nezávisle ověřená měření.
llama.cpp, vLLM nebo menší sestava
llama.cpp je vhodnější pro jednoho uživatele, interaktivní generování a situace, kde lze část modelu ponechat na CPU. Sloty umožňují zpracovat více požadavků a kvantizovanou cache lze omezit pomocí parametrů pro kvantizaci klíčů a hodnot, například:
llama-server --model [model].gguf --cache-type-k [kvantizace_k] --cache-type-v [kvantizace_v]
Formát GGUF a možnost vrstveného offloadu zjednodušují experimentování.
vLLM je silnější volba pro fronty požadavků a dávkovou analýzu. Nabízí průběžné dávkování, efektivní správu KV cache a plánování pro souběžné požadavky. Pro dlouhé kontexty je nutné nastavit max-model-len a gpu_memory_utilization; kvantizovaná cache, například kv-cache-dtype fp8, může ušetřit VRAM, ale mění výslednou konfiguraci.
Menší sestava je rozumná, pokud model, kontext a souběžné požadavky společně vytvoří přijatelnou zátěž. Dvě 24GB workstation karty nabízejí omezenou výhodu oproti běžné 24GB kartě. ECC a nízká spotřeba vhodných komponent jsou užitečné, ale samy nevyřeší úzké hrdlo dekódování.
Přenositelný postup tedy nezačíná nákupem dvou procesorů EPYC. Začíná se záznamem požadovaného modelu, kvantizace, kontextu, souběžnosti a přijatelné odezvy. Teprve potom se porovnají možnosti hostitele, GPU, ECC RAM a runtime.
Co si z toho vzít
- Oddělte kapacitu vah, velikost KV cache a paměťovou propustnost.
- Pro lokální AI použijte konfiguraci modelu, ne pravidlo „0,5 GB na miliardu parametrů“.
- ECC RAM chrání dlouhý běh; výkon zajišťuje hlavně umístění a propustnost paměti.
- Druhý socket a druhá GPU pomáhají jen při správně zvoleném paralelismu nebo větší zátěži.
- Pro interaktivní práci zvolte llama.cpp, pro dávkové a paralelní zpracování vLLM.
- Měřte odděleně prompt processing a token generation; jiné rychlosti mohou ukazovat jiný problém.