// TECH SPEC SHEET
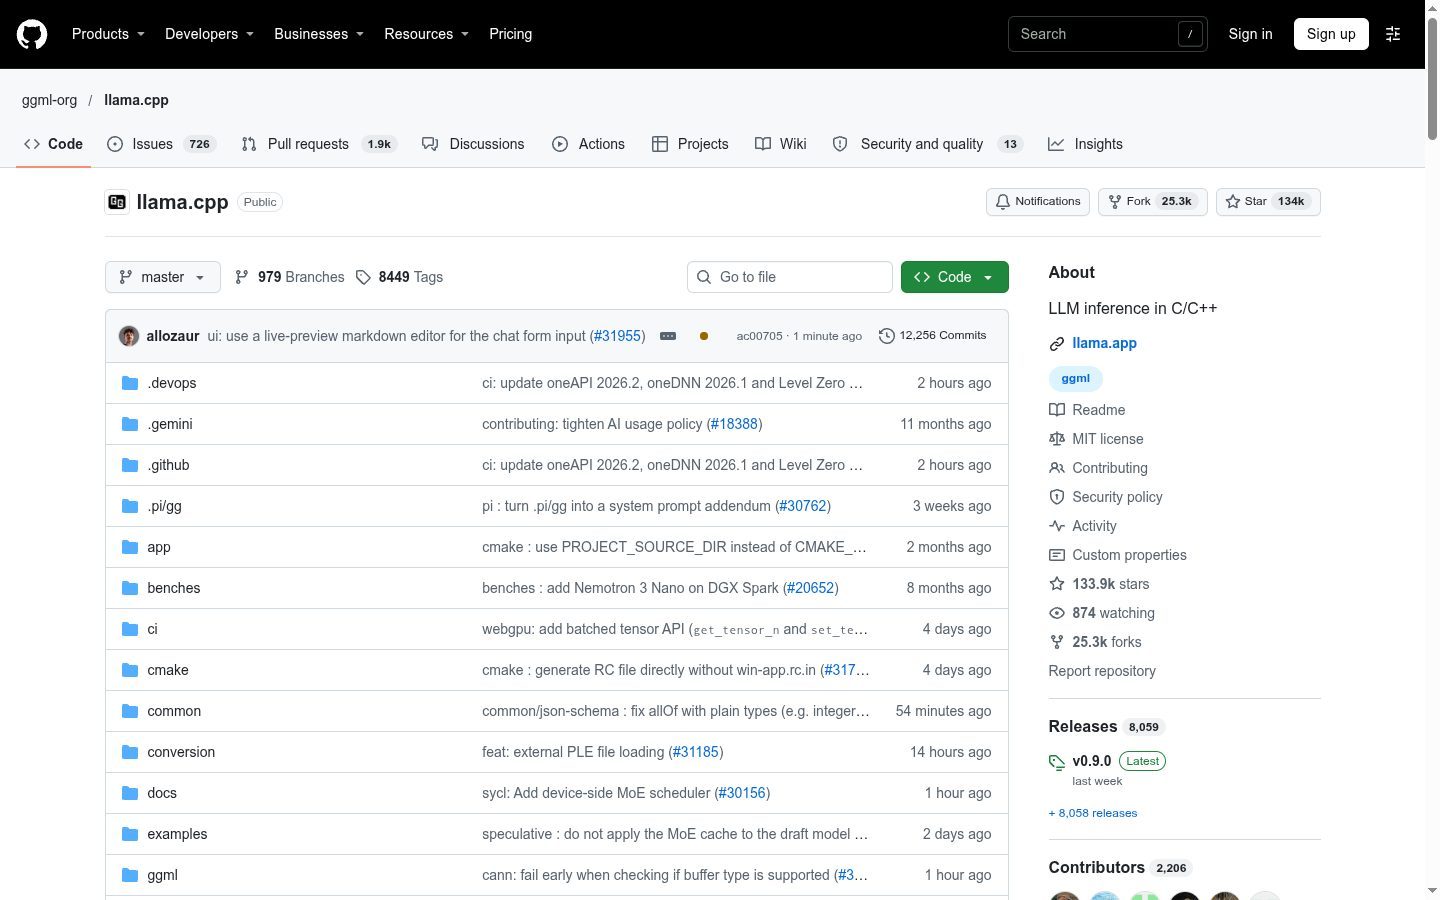
llama.cpp
Inferenční engine pro lokální LLM, vhodný pro interaktivní generování, menší modely i hybridní rozdělení práce mezi CPU a GPU.
- Druh
- Knihovna
- Výrobce / autor
- —
- Web
- github.com
- Článků
- 1
- Ověřeno v labu
- ✓ ano
// Kde jsme nástroj použili na namodro.cz
- Návody & Prompty Server pro lokální LLM: RAM, GPU a backend podle skutečné zátěže
Jak z kapacity modelu a kontextu vypočítat potřebu serveru, kdy pomůže ECC RAM a dual-socket a kdy zvolit llama.cpp, vLLM nebo menší sestavu.