Lokální AI agent na notebooku: oddělte model od agenta a skriptů
Jak na notebooku s 8 GB VRAM oddělit model, agenta, vyhledávání a spouštění skriptů, aby citlivá data zůstala lokálně a workflow bylo bezpečnější.
Architektura před výběrem modelu
Má lokální AI agent na notebooku vlastně šanci být bezpečný jen proto, že běží lokálně? Ne. A právě tady se diskuse dostala k nejdůležitějšímu závěru: model je jen jedna vrstva. Skutečné riziko může přijít z jiného směru — z agenta, připojených složek nebo povolených nástrojů.
Diskuze proto nabízí funkční kombinaci LM Studio a Cline. Její přínos nespočívá v konkrétním modelu, ale v rozdělení odpovědností:
- Model generuje odpověď a rozhoduje, kdy požádat o nástroj.
- Agent jako Cline připravuje prompt, předává modelu schémata nástrojů a vyhodnocuje výsledky.
- Vyhledávání a zpracování souborů mají být oddělené služby s vlastním přístupem k datům.
- Skripty se spouštějí v izolovaném prostředí, ideálně bez přístupu k síti.
Autor nakonec propojil notebook přes LM Studio s virtuální mašinou a nechal agenta spouštět připravené skripty bez otevřené konzole. Diskuze přinesla i důležitou opravu původního návrhu: samotná lokální inference neznamená, že celý systém nikam neodesílá data. Rozhodující jsou také konfigurace agenta, připojené složky a povolené nástroje.
U firemních dat začněte konkrétní úlohou, ne celým úložištěm. Potřebujete upravit kód? Vyberte soubory a předejte modelu jejich obsah. Agent musí procházet libovolně celým úložištěm? Pak jsou výběrové načítání a pevný kontext podstatné.
Model pro GPU s 8 GB VRAM
Z diskuse se jako funkční volba ukázal Qwen 3.5 9B, ale zkušenost s dlouhým kontextovým oknem se na 8 GB GPU nepotvrdila. Jeden z diskutujících zmiňoval také GPT-OSS 20B, případně menší modely pro jednodušší klasifikaci a extrakci. Ve výběru je NVIDIA Nemotron 3.5 Bolt E4B, uváděný ve čtyřbitové kvantizaci s potřebou přibližně 5 GB VRAM.
Veřejně je ověřeno, že kvantizovaný Qwen3.5-9B může běžet na GPU s 8 GB VRAM. Konkrétní zkušenost s uvedenou sestavou však z dostupných údajů nelze potvrdit.
Samotný počet parametrů ale neurčuje výsledek. Rozhodující jsou také formát uložení, délka kontextu, způsob práce s nástroji a velikost systémového promptu.
Pro práci s kódem může být praktičtější menší model nebo specializovaný nástroj, například Aider, který pracuje s textem a diffem, místo s rozsáhlým systémem nástrojů.
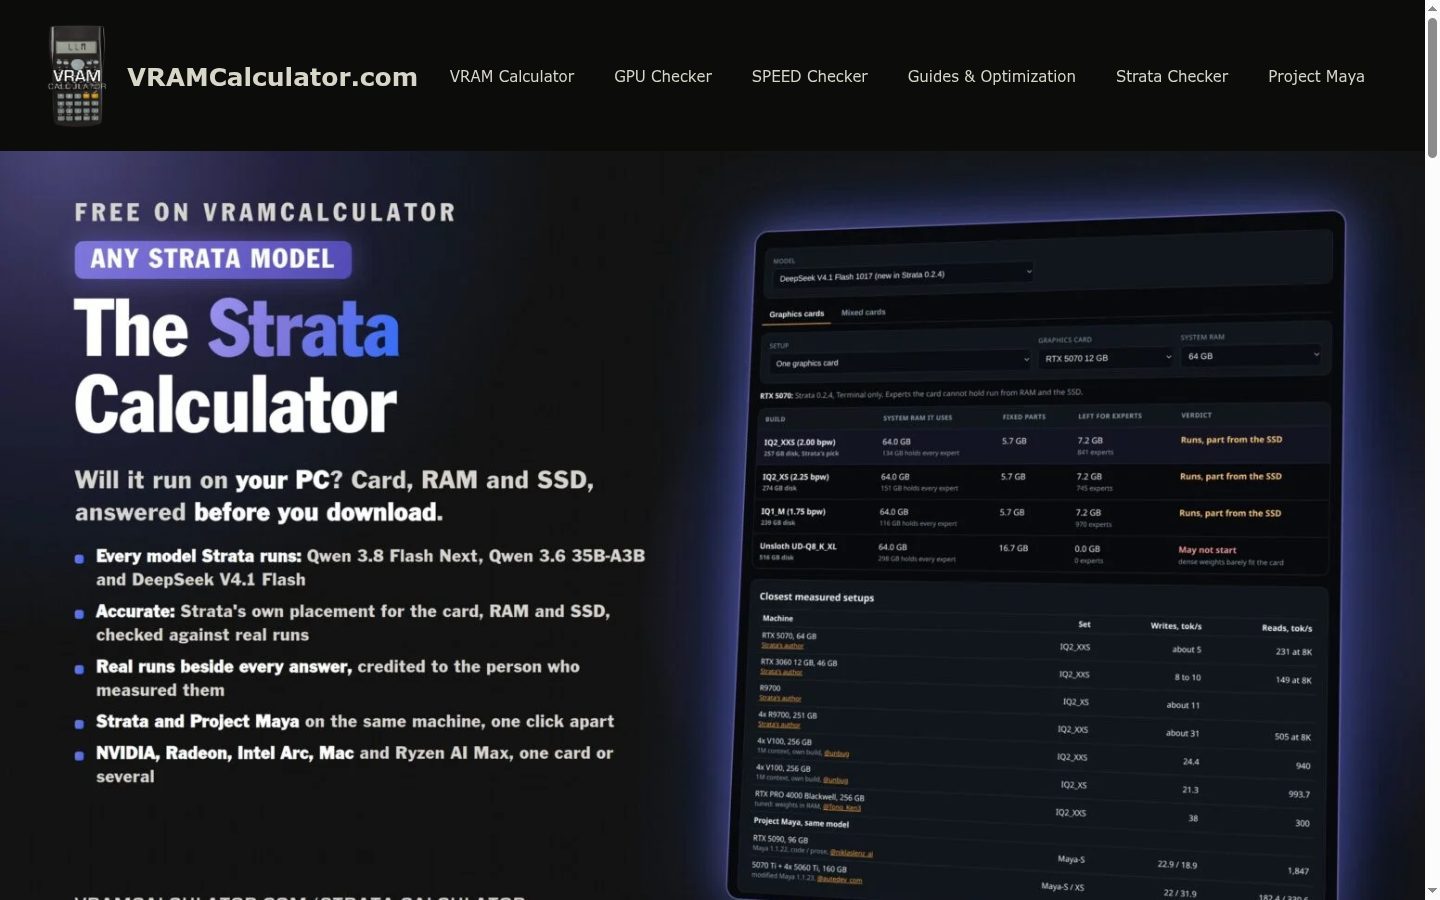
Oficiální kalkulačka VRAM, kterou jsme ověřili, se týká modelu Strata, nikoli výše uvedených modelů. Pro konfiguraci RTX 5070, 64 GB RAM, kontext 32K a kvantizaci IQ3_S uvádí potřebu 56,8 GB RAM a rozdělení části dat na GPU. Stránka označuje tento režim jako použitelný, ale výsledek „Runs“ nezaručuje konkrétní rychlost ani kvalitu.
Kalkulačka VRAM zobrazuje odhad paměti pro model Strata; její výsledky nelze přímo přenášet na Qwen nebo GPT-OSS.
Řešení problému s indexací
Největší provozní pastí diskuse bylo připojení sdílených složek k LM Studio. Aplikace je začala indexovat hned po spuštění a ve virtuální mašině pak selhala nebo se dlouho inicializovala. Řešení není jen „vypnout Vulkan“, ale oddělit data od runtime a omezit rozsah průchodu.
Prakticky pomáhá:
- Do modelu nepřidávat celé sdílené úložiště.
- Vybrat konkrétní soubory pomocí podpory typu
@file:nebo ručně. - Nastavit pevný kontext, například 8–16K tokenů.
- U delšího kontextu zapnout kvantizaci KV cache na Q8, pokud to podporuje zvolené zadání.
- Udržovat mapu repozitáře například pomocí Tree-sitter a do kontextu vkládat jen relevantní části.
Automatické čtení souborů a výstupů nástrojů rychle spotřebovává kontextové okno. Do něj se proto vejde jen výběr dat, nikoli celý souborový strom.
Menší modely navíc nemusí spolehlivě dodržovat JSON schémata nástrojů. Zkrácení promptu ušetří tokeny, ale může odebrat modelu část schopností, tedy i práci s MCP. Při 8 GB VRAM je proto rozumnější omezit nástroje než ponechat agentovi velký systémový prompt a dlouhou historii.
Jak to funguje pod kapotou a kde má postup limity
Toto řešení je agentní harness: model dostává textový úkol, systémová pravidla a popis dostupných nástrojů. V diagramu diskuze proto nejsou „jen LM Studio a Cline“, ale čtyři oddělené vrstvy.
Agentní smyčka opakuje cyklus „vyhodnotit úkol → vybrat nástroj → přečíst výsledek → pokračovat“. Každý krok přidává do kontextu prompt, historii, výstup terminálu nebo obsah souboru. KV cache přitom roste s délkou kontextu, počtem vrstev a hlav a zaujímá část omezené VRAM. Při nedostatku paměti se může přesouvat do systémové RAM přes PCIe a výrazně zpomalit odpovědi.
Plná virtuální mašina poskytuje silnou izolaci, ale je těžší a pomalejší než úzce omezený kontejner. Pro připravené skripty je obvykle přesnější kontejner bez sítě, allowlist příkazů a lidské schvalování každého spuštění. VM má smysl tam, kde skripty potřebují vlastní operační systém nebo silnější oddělení.
Model, KV cache a druhý operační systém navíc závisejí na dostupné paměti. Notebook s 8 GB VRAM a 32 GB RAM může být použitelný, ale ne automaticky rychlý. Malý model navíc nemusí převést výhodu plné lokality ve spolehlivý průchod vícestupňovou úlohou. Malý 7–8B model s agentickým harnessem tak není spolehlivou alternativou výkonnějšímu lokálnímu modelu Claude.
Kdy použít který nástroj
- Cline + LM Studio: univerzální lokální agent pro práci s vybranými soubory a omezenými nástroji.
- Ollama a Open WebUI: jednoduché lokální rozhraní pro běžné dotazy a menší automatizace, nikoli nutně plné agentní workflow.
- Aider: úpravy kódu přes diff, vhodné pro omezenou VRAM.
- Kontejner: spouštění předem připravených skriptů s omezenou sítí a schvalováním.
- Cline s Compact Prompt: menší systémový prompt, pokud není potřeba plná integrace s MCP.
Checklist pro citlivá data
- Model i inference běží lokálně; zakázat nebo hlídat síťové pluginy a telemetry.
- Agent má přístup jen k vybraným souborům.
- Každý skript je spuštěný z pevného obrazu, bez přímého přístupu k internetu.
- Příkazy, síťové požadavky a zápisy mimo pracovní adresář vyžadují schválení.
- Zobrazuje se využití VRAM, RAM, kontextu a délky promptu.
- Výstupy se před zveřejněním kontrolují na citlivé údaje.
- Pravidelně se ověřuje, zda se nezměnila síťová nebo adresářová oprávnění.
Co si z toho vzít
- Oddělte model, agenta, vyhledávání a spouštění skriptů.
- Na 8 GB VRAM začněte menším modelem a kontextem 8–16K.
- Nepřipojujte celé sdílené složky k modelu; vybírejte konkrétní soubory.
- Pro připravené skripty upřednostněte omezený kontejner před plnou VM, pokud skripty nevyžadují vlastní operační systém nebo silnější izolaci.
- Měřte VRAM, RAM, tokeny kontextu a dobu odezvy.
- Lokální inference je jen jedna hranice bezpečnosti; síť, pluginy, soubory a oprávnění je nutné řídit zvlášť.
Cíl: [co má agent upravit nebo vyhledat]

Model: [název a kvantizace]
Kontext: [například 8–16K tokenů]
Soubory: [konkrétní cesty, ne celé úložiště]
Nástroje: [povolené nástroje a akce]
Izolace: [kontejner nebo VM]
Síť: [vypnuto nebo povolený allowlist]
Schvalování: [které kroky vyžadují schválení]

Před spuštěním skriptu zkontrolovat:
[seznam schválených příkazů, zápisů a síťových požadavků]

Po spuštění zkontrolovat:
[seznam výstupů, změn souborů a případných citlivých údajů]