⚡ 78,7k tokenů · 5 modelů · Výpočetní stopa ▾
Které AI modely se na článku podílely a kolik tokenů spotřebovaly (vstup / výstup).
| Model | Role | Kde běží | Vstup | Výstup | Volání |
|---|---|---|---|---|---|
| MiniMax | plánování námětu | cloud | 16,2k | 780 | 1 |
| MiniMax | návrh článku | cloud | 13,0k | 2,8k | 1 |
| MiniMax | faktová oprava | cloud | 7,3k | 3,1k | 1 |
| MiniMax | ověření faktů | cloud | 6,3k | 766 | 2 |
| MiniMax | stylistika | cloud | 3,4k | 3,0k | 1 |
| Qwen 35B | zpracování rešerše | lokálně | 2,7k | 2,4k | 2 |
| Qwen 35B | audit přínosu | lokálně | 2,2k | 1,8k | 1 |
| gemini-flash (Antigravity) | jazyková korektura | cloud | 1,9k | 1,8k | 1 ~ |
| MiniMax | hodnocení přínosu | cloud | 3,5k | 147 | 1 |
| Gemma Vision | kontrola screenshotů | lokálně | 2,9k | 304 | 2 |
| perplexity (Grok 4.7) | audit přínosu | cloud | 249 | 1,2k | 1 ~ |
| perplexity (Grok 4.7) | ověření faktů | cloud | 144 | 857 | 1 ~ |
~ odhad: Perplexity a korektura Gemini běží mimo naši bránu, tokeny se odhadují z délky textu.
Qwen3.8 na lokálních GPU: rychlost, paměť a vlastní benchmark
Jak porovnat Qwen3.8 Flash Next a 27B na RTX PRO 6000 či RTX 3090? Návod k měření propustnosti, TTFT, VRAM/RAM a kvality bez zavádějícího porovnání.
Co znamená vyšší počet tokenů za sekundu? Je to skutečně rychlejší model, nebo jen rychlejší načtení promptu? U Qwen3.8 na lokálních GPU je odpověď složitější: výsledek ovlivňuje hardware, kvantizace, délka kontextu i způsob měření.
Proto nestačí uvést samotné „tok/s“. U Flash Next a 27B je potřeba oddělit rychlost načítání promptu, rychlost generování, čekání na první token a chování při souběžných požadavcích. Stejně tak je nutné oddělit kvalitu textu od výkonu a uvést přesnou konfiguraci.
Co se řeší v komunitě
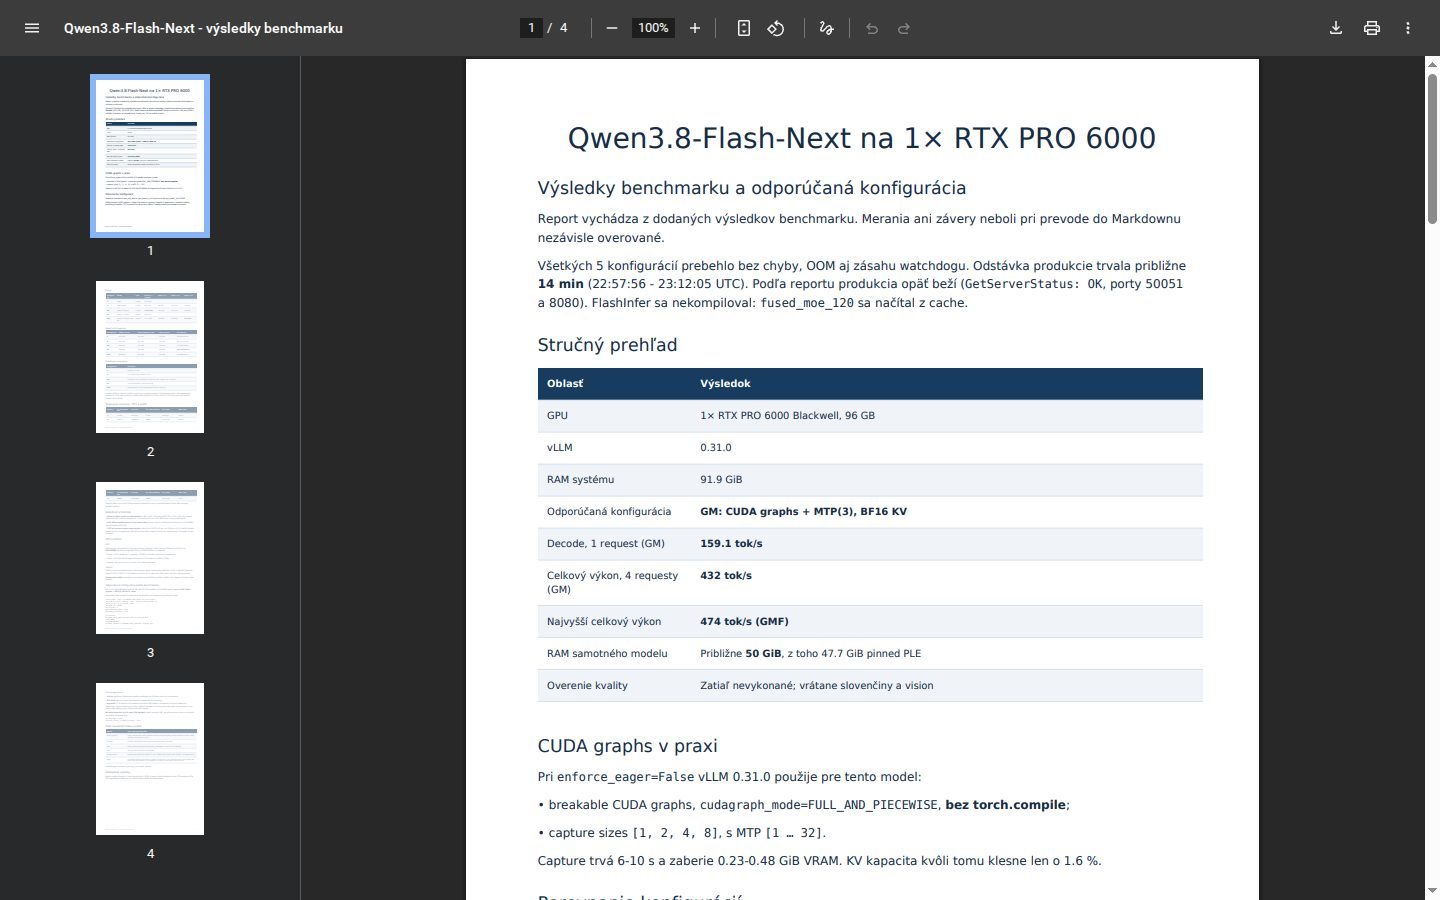
Na RTX PRO 6000 s 96 GB VRAM byl podle zúčastněných v diskusi Flash Next spuštěn přes vLLM ve verzi 0.31.0. Testovaná varianta NVFP4 s PLE tabulkou zabírala přibližně 48 GB systémové RAM.
Jeden z diskutujících uváděl kolem 28,3 tokenu za sekundu při 32K kontextu. Další zkušenosti se pohybovaly přibližně mezi 28 a 35 tok/s. U jiného hardwaru se objevovaly i výrazně vyšší hodnoty, včetně dvou RTX 3090 a enginu Strata. Bez úplné reprodukovatelné konfigurace je ale nelze použít jako srovnání.
Rozdíl mezi mmap a předem alokovanou RAM se týká především načítání modelu do VRAM. Při mmap je přenos podle zkušeností pomalejší. Předem alokovaná RAM umožňuje rychlejší následné streamování, ale testování různých konfigurací trvá déle. Načítání proto musíte měřit odděleně od generování.
Ani samotný název formátu nezaručuje kvalitu. Diskuse upozorňuje na záměny znaků u varianty IQ3_S při delším kontextu. Rozhodující může být rozložení jednotlivých tenzorů a to, které části modelu kvantizace skutečně zkracuje.
PLE tabulka navíc není libovolně dělitelná. Její umístění na SSD může začít brzdit až při vysokých rychlostech generování.
Praktickým know-how diskuse je nevolit „nejmenší kvantizaci“, ale porovnat několik variant na stejném hardwaru a stejném workloadu. Samostatně otestujte krátký a dlouhý kontext, jedno vlákno i více souběžných požadavků.
Jak to funguje pod kapotou a kde má postup limity
Odborně jde o kvantovanou inferenci lokálního MoE modelu s možným vrstveným uložením na RAM, VRAM a SSD. Rozdíl „tok/s“ v sobě spojuje několik různých fází:
- Prefill zpracovává prompt a je výrazně výpočetně náročný.
- Decode generuje další tokeny a při čtení vah z VRAM naráží na propustnost paměti.
- TTFT měří dobu do prvního tokenu a zahrnuje čekání fronty i zpracování promptu.
- Propustnost vyjadřuje celkový počet vygenerovaných tokenů za sekundu, případně z jednoho či více klientů.
Kvantizace snižuje objem čtených vah, ale sama o sobě nezaručuje kvalitu. Chyby se podle kritického auditu mohou soustřeďovat zejména v outlier kanálech aktivací a logitů.
U volného textu nemusí být patrné. Při strukturovaném výstupu však mohou překlopit výběr tokenu. Přesná shoda s JSON schématem je proto důležitější než samotná perplexita.
Také offload není binární přepínač. Pokud se na CPU přesune attention, dlouhý kontext může výrazně zpomalit. V jednom z auditovaných případů klesla rychlost z 54 na 9,5 tok/s.
Rozhoduje, které vrstvy a kteří experti zůstanou na GPU. U MoE router sice aktivuje jen část expertů, attention a KV cache však stále rostou s délkou kontextu.
Na 24 GB VRAM může o osazení rozhodovat KV cache, nikoli samotné váhy. U constrained decodingu a tool-callingu je navíc nutné zaznamenat validní strukturu výstupu. Speculative decoding nebo MTP bez údaje o acceptance rate nelze podle výsledného toku srovnávat.
Vlastní benchmark: co skutečně měřit
Připravte jeden řetězec promptů se stálou délkou. Patří do něj krátký chat, dlouhý český dokument, kód, OCR a slovenský text. Pro každý běh zaznamenejte:
- TTFT v milisekundách.
- Tok/s během decode.
- Celkovou propustnost při souběhu.
- Špičkovou a průměrnou spotřebu RAM a VRAM.
- Délku fronty, dobu čekání a případné výpadky.
- Chybovost odpovědi a validitu JSON schématu.
Měřte zvlášť prefill a decode. Při testu paralelního zpracování použijte stejný počet slotů, kontext a KV dtype. Jinak porovnáváte různé experimenty, nikoli enginy.
Pro kvantizace ponechte stejný formát vah. GGUF, AWQ a NVFP4 nejsou záměnné varianty jednoho měření.
Reprodukovatelný záznam má obsahovat model, přesnou kvantizaci, engine a verzi, délku promptu, kontext, KV dtype, batch a ubatch, počet slotů, teplotu i seed. Teprve potom lze výsledky porovnat.
Pro reprodukovatelný běh můžete použít následující šablonu:
Model: [název modelu a revize]
Kvantizace: [typ a přesné označení varianty]
Engine a verze: [např. vLLM 0.31.0]
Formát vah: [GGUF/AWQ/NVFP4/jiný]
KV dtype: [fp16/bf16/fp8/jiný]
Prompt: [typ úlohy, délka v tokenech a jazyk]
Kontext: [maximální kontext]
Batch / ubatch: [hodnoty]
Sloty / souběžné požadavky: [počet]
Dekódování: [teplota, top-p, top-k, seed]
Další optimalizace: [speculative decoding, MTP, offload a podrobnosti]
Kdy použít kterou kartu a jak rozdělit práci
Podle diskuse se Flash Next na RTX PRO 6000 vešel do 96 GB VRAM i s PLE tabulkou v systémové RAM. Můžete tak testovat vyšší bitovost bez změny topologie.
Dvě RTX 3090 můžete využít pro souběh nebo dělení rolí. Výsledky však musíte měřit při stejném nastavení.
Praktické rozdělení je:
- silnější karta: plánování a dlouhé generování;
- druhá karta: analýza dokumentů nebo OCR;
- samostatný model nebo menší kvantizace: kontrola struktury a faktů.
Předem alokovaná RAM je vhodná pro opakované pokusy s různými modely. mmap nebo úložiště na NVMe může být praktickým kompromisem, pokud šetří RAM. Zahrňte ale naměřený čas načtení do výsledku.
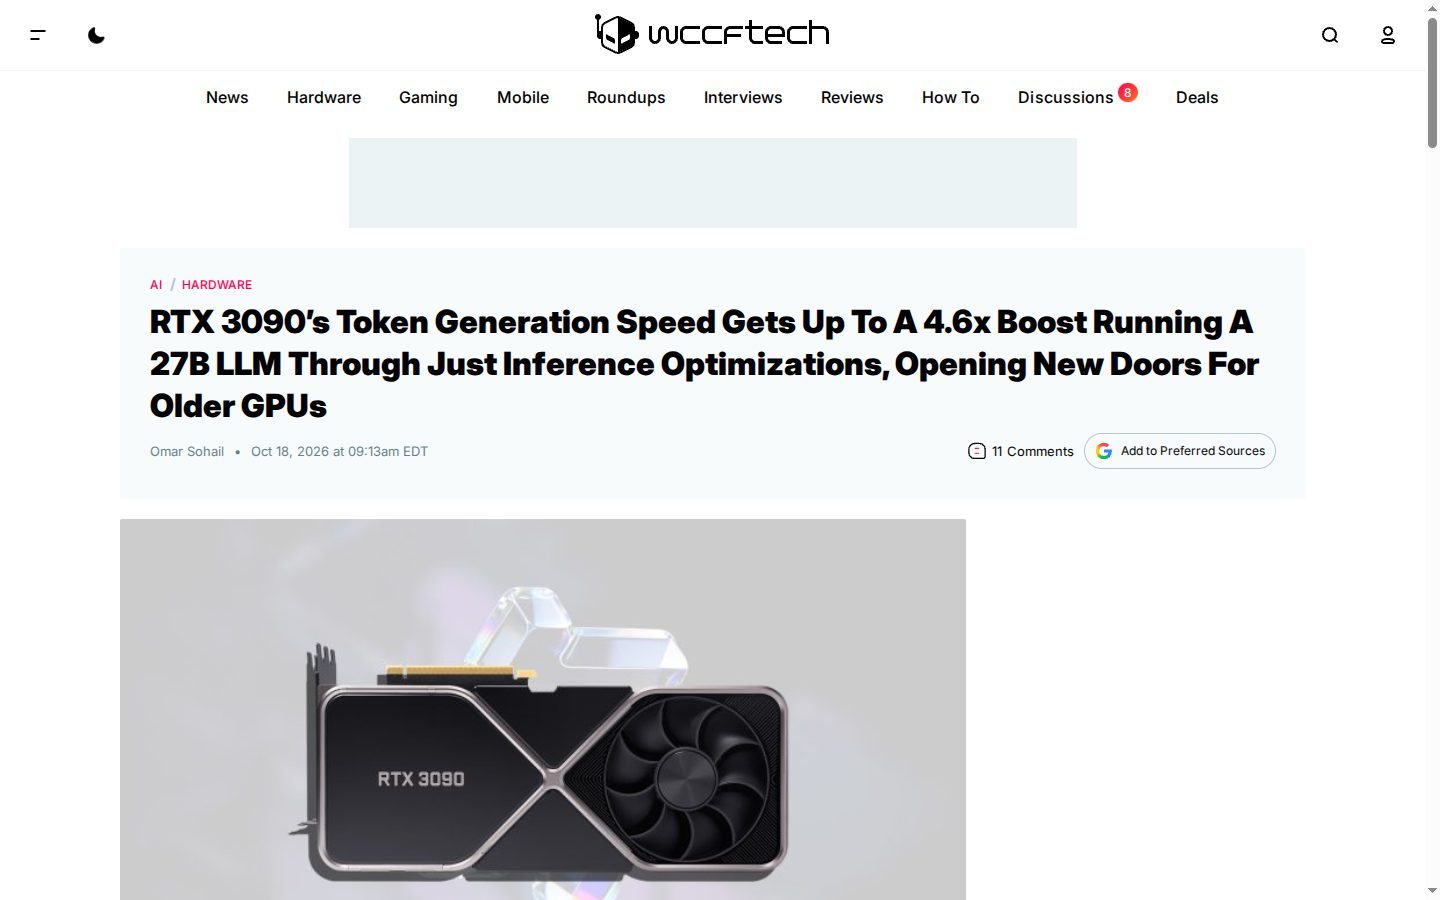
Externí článek popisuje zrychlení modelu Qwen3.8-27B na RTX 3090 pomocí speculative decodingu a MTP. Udává zrychlení z 82 na 114 tok/s s MTP, na 138 tok/s s DFlash2 a lookup drafterem. V jednom scénáři dosáhl 382 tok/s při práci s dokumentem o délce 25 000 tokenů.
Jde o výsledek převzatý z Redditu, který nebyl nezávisle ověřen. Chybí také podrobnosti o implementaci a acceptance rate. Uvedené hodnoty proto nelze přenést na jiný systém ani přímo porovnávat s testem Flash Next na RTX PRO 6000.
Co si z toho vzít
Samotné tok/s nestačí. Doplňte TTFT, prefill, propustnost, fronty a využití paměti. Porovnávejte stejný formát vah, kontext, KV dtype, délku promptu a počet slotů.
IQ3_S a další 3bitové varianty testujte na dlouhém kontextu i na českých a slovenských reáliích. Při agentních úlohách měřte validitu JSON schématu, nejen přirozenost textu. Offload hodnoťte podle umístění jednotlivých vrstev, ne jako jedinou vlastnost celého modelu.
Dvě GPU jsou užitečné pro rozdělení plánování, analýzy a kontroly výstupu. Výsledky musí vznikat ze shodných testů.
Praktický závěr je jednoduchý: nejprve změřte celý řetězec od načtení přes prompt až po finální token a zaznamenejte jeho konfiguraci. Teprve pak můžete rozhodnout, která karta a kvantizace vyhovují vašemu workloadu.