Prompt caching: jak ušetřit při pokračování dlouhého projektu
Nově je jasné, že cache v UI a v API nejsou totéž. Prompt caching ušetří část nákladů na opakovaný výpočet, ale neodstraňuje limity, účtování nových tokenů ani potřebu verzovat stav projektu.
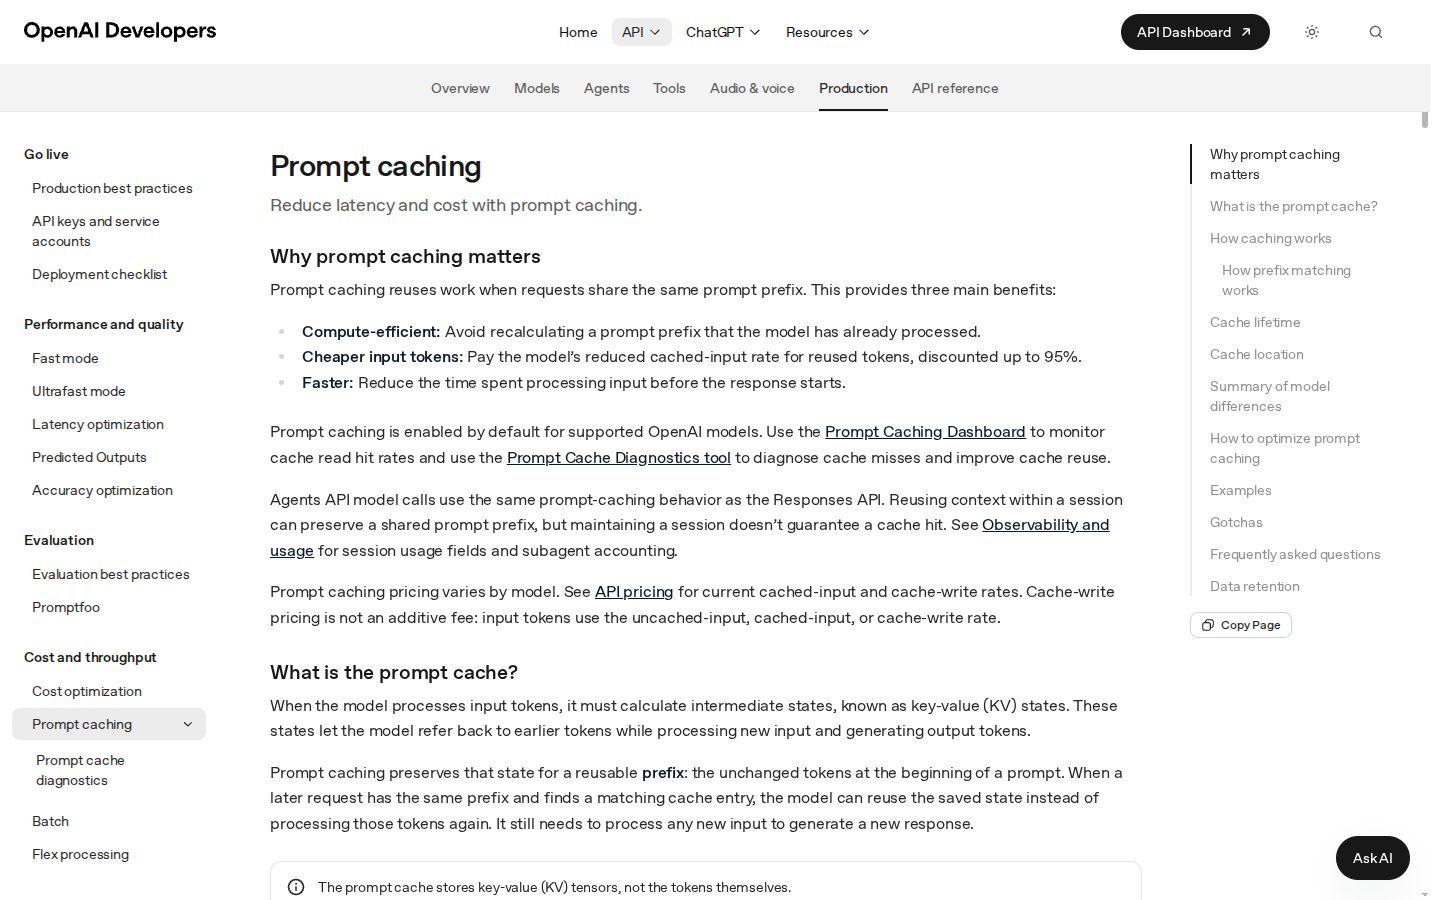
Prompt caching není trvalá paměť projektu. Umožňuje však znovu využít část výpočtu stejného prefixu promptu, takže pokračování ve starším vlákně může stát méně než jeho zpracování od začátku. Právě tento rozdíl je důležitý: uložený chat, pracovní kontext a cache v API jsou tři různé věci.
Komunita se rychle chopila formulace „Codex a Work průběžně uchovávají kontext konverzace“. Praktický přínos je jasný: do staršího vlákna lze po delší pauze navázat a část už zpracovaného obsahu se znovu využije levněji. Pro přesnost je ale nutné tuto zprávu opravit. Nejde o nový druh trvalé paměti projektu, ale o prompt caching – mechanismus, který šetří opakovaný výpočet stejného prefixu promptu.
Rozhraní a API nejsou totéž
Rozdíl mezi rozhraním a API je zásadní. Oficiální dokumentace OpenAI k ChatGPT Work a Codex popisuje synchronizaci chatů, samostatnou historii Codexu a ukládání zpráv a kontextu úloh v cloudu. Neurčuje však, že by kontext přihlášeného uživatele zůstával v neomezené mezivýsledné podobě. Tvrzení o „cache bez časového omezení“ proto nelze vydávat za ověřenou záruku.
V Responses API je naopak doba životnosti součástí konfigurace. Pro novější modely lze nastavit prompt_cache_options.ttl: "12h". Jde o minimální životnost, nikoli přesný čas smazání ani záruku, že další stejný prompt zasáhne do cache. Dvanáct hodin proto není totéž co „cache funguje vždy dvanáct hodin poté“.
Dokumentace OpenAI popisuje cachování jako znovuvyužití výpočetního stavu stejného prefixu promptu.
Účtování se týká vstupních tokenů a nově zpracované části; trvání uloženého stavu je oddělená věc.
Co se změnilo a co zůstalo stejné
Komunitní zpráva má dvě části. První z nich, návrat do staršího vlákna, odpovídá principu opakovaného použití stejného prefixu. Druhá, „bez časového omezení“, je příliš široká a oficiální dokumentace ji nepotvrzuje. Užitečné je, že se diskuse zaměřila na kontinuitu práce, nikoli na odpočet limitů.
V UI může uložená konverzace zůstat dostupná pro lidskou práci s historií. To je ale jiná vlastnost než cache v API. Historie chatu jsou aplikační data; prompt cache je mezivýsledek vytvořený během zpracování promptu. Její dostupnost, životnost a způsob účtování nelze zaměňovat.
Také formulace „pauza vás nebude stát další limit“ je nepřesná. Cache může snížit cenu a latenci znovu zpracovaného prefixu, ale nové požadavky se nadále účtují. Výraznější úsporu proto přináší dlouhý stabilní úvod a opakované použití téhož kontextu, nikoli samotné čekání.
Jak to funguje pod kapotou a kde má postup limity
Při zpracování promptu transformer vytváří pro jednotlivé tokeny klíče a hodnoty potřebné pro mechanismus attention. Uložený stav se označuje jako KV cache. Umožňuje znovu použít výpočet shodného začátku promptu místo jeho opakovaného zpracování.
Cache neuchovává text konverzace ani hotovou odpověď. Uchovává výpočetní stav pro nezměněnou část vykresleného promptu. Při pokračování se musí shodovat prefix včetně systémových pokynů, historie, nástrojů a dalších relevantních nastavení. Změna modelu, schématu nástrojů, reasoning effort nebo kompakce může shodu přerušit už od prvního změněného tokenu.
Pro GPT-5.6 a novější modely je minimální cacheovatelná délka 1 024 viditelných vstupních tokenů. U starších modelů závisí na konkrétním nastavení požadavku a skrytý systémový obsah se do minima nezapočítává.
Zásah navíc závisí na umístění cache na konkrétním stroji a na směrování požadavku. Při více než 15 požadavcích za minutu může dojít k přesměrování přes zátěž na uzel, kde příslušná položka není. Dokumentace proto varuje před předpokladem garantovaného hitu. Ani platné pokrytí cache nezaručuje nižší latenci.
Cache jsou vázané na jednotlivé stroje a nejsou sdíleny mezi organizacemi ani mezi regionálními hranicemi zpracování.
Cache je slevou na zpracování vstupu. Dokumentace uvádí úsporu až 95 % oproti běžné ceně vstupu; aktuální sazby stanovuje ceník API. Cache není spolehlivým zdrojem pravdy, trvalou pamětí projektu ani náhradou verzovaného stavu v repozitáři nebo databázi. Dvanáctihodinové TTL proto nelze používat jako záruku dostupnosti.
Kdy lze úsporně navázat na starší konverzaci
V UI je rozumné pokračovat ve stejném vlákně, pokud se nezměnily základní instrukce ani nástroje a konverzace má jednoznačný pracovní kontext. Výhodnější je pokračovat bez přepisování starých zpráv a bez vkládání nové varianty systémových pokynů.
V API je postup řízenější. Stabilní systémové instrukce, definice nástrojů a opakovaně používané reference patří do předního prefixu. Aktuální otázka má být na konci. Pro GPT-5.6 a novější modely lze využít explicitní breakpointy a označit místo, za kterým už se prefix mění. Dokumentace u těchto modelů popisuje také implicitní breakpoint na konci nejnovější způsobilé zprávy a reportování přesné vymezující hranice.
Dokumentace zmiňuje také rozdílné možnosti retence podle potřeb a podporovaných modelů. Konkrétní nastavení je proto vhodné ověřit v aktuální dokumentaci a ceníku, zejména před použitím delší retence.
Praktické tipy pro dlouhá projektová vlákna
Udržujte rozhodující zadání, konvence a stav projektu mimo konverzaci. Verzujte kód, ukládejte rozhodnutí do dokumentace a u citlivých údajů nepředpokládejte, že cache nahrazuje zabezpečené úložiště.
Před experimentem rozlišujte tři položky: dostupnou historii chatu, skutečně znovu využitou cache a nově zpracované tokeny. Bez reportingu cache nelze z úsporného pokračování vyvozovat, že se celý požadavek účtoval jako neopakovaná práce.
Pro cenově citlivé API aplikace vytvořte stabilní prompt, měňte pouze závěr a kontrolujte aktuální ceník. Pro dlouhé interaktivní projekty ponechte konverzační historii čitelnou a pravidelně vytvořte stručné shrnutí rozhodnutí, otevřených úkolů a testovacího stavu.
Co si z toho vzít
- Prompt caching šetří opakovaný výpočet stejného prefixu, nikoli celý nový požadavek.
- Uložený chat, pracovní kontext a KV cache jsou tři různé věci.
- Dvanáct hodin v API je minimální retence, ne záruka trvalého uložení ani zaručeného hitu.
- Pro úsporné pokračování udržujte stabilní prefix a měňte pouze konec promptu.
- Důležitý stav projektu patří do verzovaných souborů, ne pouze do historie AI chatu.
- Codex je praktický pro práci s dlouhými projektovými úlohami, ale jeho historie nenahrazuje zdrojový kód, dokumentaci ani explicitní rozpočet pro AI.