⚡ 52,1k tokenů · 4 modely · Výpočetní stopa ▾
Které AI modely se na článku podílely a kolik tokenů spotřebovaly (vstup / výstup).
| Model | Role | Kde běží | Vstup | Výstup | Volání |
|---|---|---|---|---|---|
| MiniMax | návrh článku | cloud | 13,6k | 2,7k | 1 |
| MiniMax | faktová oprava | cloud | 7,6k | 3,2k | 1 |
| MiniMax | stylistika | cloud | 3,2k | 2,8k | 1 |
| MiniMax | ověření faktů | cloud | 5,3k | 457 | 2 |
| Qwen 35B | audit přínosu | lokálně | 2,3k | 2,4k | 1 |
| gemini-flash (Antigravity) | jazyková korektura | cloud | 1,7k | 1,7k | 1 ~ |
| MiniMax | hodnocení přínosu | cloud | 3,2k | 146 | 1 |
| perplexity (Grok 4.7) | audit přínosu | cloud | 249 | 1,3k | 1 ~ |
| perplexity (Grok 4.7) | ověření faktů | cloud | 138 | 249 | 1 ~ |
~ odhad: Perplexity a korektura Gemini běží mimo naši bránu, tokeny se odhadují z délky textu.
Matching decompilation: jak AI rekonstruuje starý DOSový program
Postup obnovuje překladově ekvivalentní zdrojový kód, nikoli originální syntaxi. Ukážeme, kdy pomáhají agenti, proč je klíčový historický kompilátor a jak oddělit logiku od DOSu.
Obnovit starý DOSový program tak, aby po překladu vznikla binárka shodná bajt po bajtu s originálem? Matching decompilation řeší tento problém. Neobnovuje však původní zdrojový soubor. Sestavuje překladově ekvivalentní rekonstrukci: zdrojový kód, který se stejným historickým kompilátorem přeloží do stejného výsledku.
Nejde tedy o běžnou dekompilaci do assembleru. Ta převádí strojový kód na čitelnější podobu, ale sama neprokazuje, že rekonstrukce odpovídá původnímu programu. Matching decompilation navíc zjišťuje jazyk, kompilátor, jeho verzi a nastavení. Teprve potom lze testovat konkrétní zdrojové konstrukce.
Veřejný projekt m602_scr ukazuje, že autor podle README použil Turbo Pascal 6.01 a referenční testy přehrávají 6 300 snímků pořízených z rekonstruovaného SAVER.PAS. Každý snímek se porovnává se stavem spořiče i výslednou obrazovkou. Původní textová plocha má 80×25 znaků; na displeji 16:9 projekt používá 107×25 znaků, takže znaky se neroztahují.
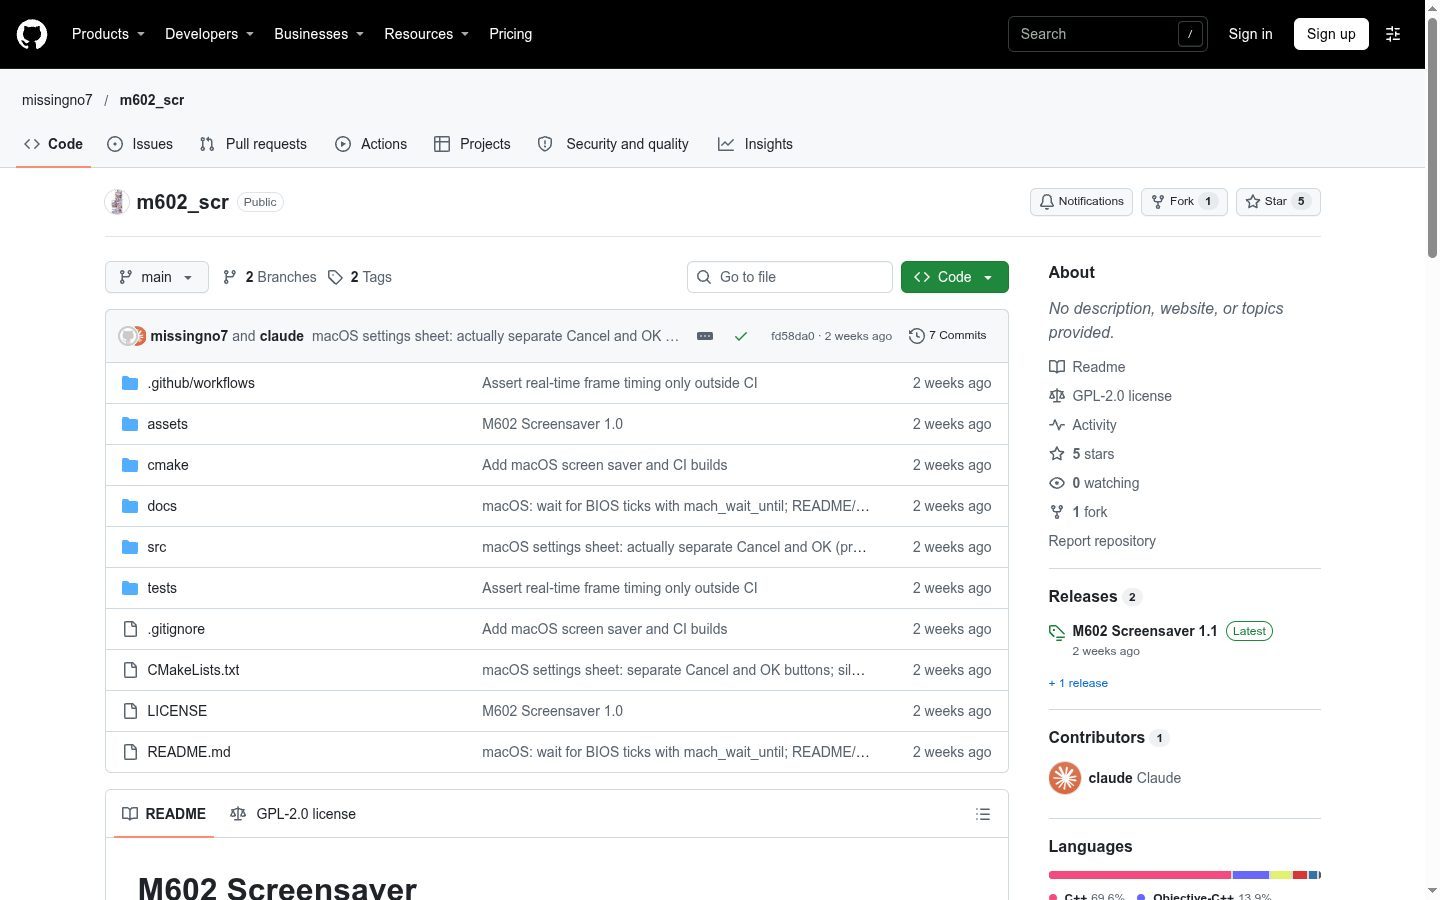
m602_scr zveřejňuje rekonstrukci i vydání pro Windows a macOS.Co skutečně obnovuje AI
Autor projektu popisuje matching decompilation M602 jako proces, při němž AI postupně skládá algoritmy, konstanty, datové struktury a chování původního programu. Původní názvy proměnných a funkcí se přitom obvykle odhadují podle kontextu. Některé stopy mohou poskytnout debug symboly, textové řetězce, sdílené knihovny nebo dokonce části původních zdrojů.
Rozhodující je shoda překladu. Stejný výsledný kód může vzniknout z více syntakticky odlišných zápisů. Konstrukce for a ručně psaný ukazatel tedy nemusí být rozlišitelné. Výsledek je správné popsat jako překladově ekvivalentní rekonstrukci, nikoli digitální kopii původního zdrojového souboru.
Praktické know-how komunity spočívá v kombinaci několika pracovních režimů:
- AI hledá opakující se vzory, datové tabulky a kandidátní implementace.
- Vlastní skripty analyzují binárku a porovnávají výstupy překladače.
- Historické kompilátory a linker poskytují opakovatelný orákul.
- Paralelní agenti řeší izolované úlohy, například různé funkce nebo datové struktury.
- Testovací harness porovnává stav a jednotlivé snímky.
Autor používal Claude Code i Codex CLI. V diskuzi popisuje také vlastní skripty pro analýzu binárek, porovnání výstupů kompilátoru a testování. Tím vzniká postupný systém, který lze přenášet mezi projekty.
Jak to funguje pod kapotou a kde má postup limity
LLM neprodukuje jediný „pravdivý zdroj“. Vzorkuje pravděpodobné jazykové konstrukce, z nichž mnohé mohou při stejných parametrech překladače vytvořit stejné instrukce. Rozhoduje tedy kombinace modelu, překladače, příznaků a následného diffu.
Shoda závisí i na dobových detailech. Volací konvence, bloky near a far, segmenty, zarovnání, přesná šířka typu int i chování knihovny CRT mohou změnit kód při stejném algoritmu. Naopak bajty nemusí odhalit, zda autor použil vlastní generátor, tabulku, LCG nebo rand().
Problém je zvlášť obtížný u přesného časování. Původní M602 pracuje s BIOS ticky: jeden krok každé dva ticky, tedy přibližně 9,1krát za sekundu. Správný překlad musí zachovat nejen pohyb, ale také pořadí aktualizací a stav sdílený mezi jednotlivými částmi.
Proto je historický toolchain s diffem důležitější než samotná dlouhá konverzace s modelem. AI je užitečná při formulaci kandidátů, čtení vzorců a práci s regresí. Mechanické alternativy zápisu však často vyřeší permuter levněji. Ghidra nebo IDA mohou poskytnout pseudokód a odkazy na kód, ale jejich výstup je hypotéza, nikoli hotová shoda.
Další omezení je právní a historické. Byte-for-byte shoda dokazuje ekvivalenci vůči konkrétnímu překladači, nikoli autorství konkrétního zdrojového kódu. U projektu M602 README neuvádí licenci původního DOSového Manažeru ani podmínky šíření jeho dat. Licence GPL-2.0-or-later se vztahuje na nový projekt, ale sama nevyřeší práva k původnímu softwaru.
Praktický workflow pro rekonstrukci
Samostatný postup lze zorganizovat takto:
- Sběr artefaktů. Zachovat originální binárku, zjistit kompilátor, verzi a příznaky. Prohledat repozitáře, dokumentaci, dumpy paměti a související projekty.
- Oddělení platformy. Vytvořit mapu závislostí na DOSu, VGA textovém módu, BIOS ticku, souborech a paměti. Izolovat algoritmus pohybu a generátoru od vstupů a výstupů.
- Kandidátní rekonstrukce. Agentům zadávat malé izolované funkce. Výsledky musí vracet do společného repozitáře, kde je lze sestavit a porovnat.
- Orákul. Překládat stejným historickým kompilátorem a porovnávat bajty. Mechanické varianty testovat bez placeného modelu.
- Chování. Spustit originál i kandidáta ve vhodném emulátoru nebo debuggeru a porovnat stav po jednotlivých snímcích, včetně časování.
- Port. Teprve po stabilizaci logiky nahradit DOSové vstupy a výstupy moderními rozhraními. Zachovat proporce 80×25 znaků bez plošného zkreslení.
Šablona promptu pro agenta může vypadat takto:
Reconstructuj chování [popis scény] z materiálů [seznam materiálů].
Přiřaď [cílový styl] a zachovej přesné přechody stavu i časování.
Uveď předpoklady, nevyřešené datové struktury a kandidátní varianty zdroje.
Odděl platformově specifický vstup a výstup od jádra logiky.
Kdy AI, kdy nástroje a kolik to stojí
Komunitní postup má smysl pro rozsáhlé projekty, kde existuje originální binárka, lze určit toolchain a chování se dá změřit. Pro menší opravu je rychlejší kombinace dekompilátoru, ruční analýzy a cíleného promptu.
Dedikované nástroje mají jasné role. Historický kompilátor a diff definují shodu. Ghidra nebo IDA slouží k orientaci v kódu. Permuter hledá levné ekvivalentní zápisy. DOSBox-X či Bochs umožňují sledovat porty, časování a stav za běhu. AI agenti pomáhají s mapováním kandidátů a přípravou testů, ale nenahradí měření.
Autor uvedl, že samotný hotový spořič stál výrazně méně, zatímco kompletní matching decompilation M602 mohl spotřebovat tokeny za více než 1 000 USD. Tento rozdíl ukazuje, kde jsou peníze nejúčinnější: ne v dlouhé generaci kódu, ale v automatizaci nástrojů, testů a rozdělení práce.
Co si z toho vzít
- Matching decompilation není převod assembleru; cílem je shodný výstup historického překladače.
- Agenti nejlépe hledají lokální vzory, zatímco globální datové struktury vyžadují lidský dohled.
- Původní kód nelze obecně obnovit doslova; lze získat překladově ekvivalentní rekonstrukci.
- Testovací orákul musí pocházet z binárky a chování, ne jen z přesvědčivé syntaxe modelu.
- Aplikační logiku je nutné oddělit od DOSu, hardwaru, paměti a časování ještě před portem.
- Před nasazením je potřeba ověřit také právní status původního softwaru a dat.