Jak ověřit aktuální funkce, ceny a limity AI nástrojů
Praktický postup, jak ověřit ceny, limity a funkce AI produktů v oficiální dokumentaci, na vlastních registrech zdrojů a ve stavu konkrétního účtu.
Proč model zná produkty jen přibližně
Cena, limit nebo nová funkce se v AI nástroji může změnit ze dne na den. Model ale nemá přístup k aktuálnímu stavu produktu, takže na otázku „Kolik stojí?“ může odpovědět podle starší verze dokumentace. U kvót a kreditů je taková odpověď ještě rizikovější: pár neaktuálních čísel může vést k chybnému rozhodnutí.
ChatGPT nemá interní databázi, do níž by se průběžně zapisovaly změny cen, limitů nebo rozhraní. Významnou část jeho odpovědí generuje z parametrů natrénovaných na textových datech. Informace o nové funkci proto nemusí být v tréninkových datech a starší verze produktu může přetrvávat i poté, co se dokumentace změní.
Generativní model navíc místo přiznání chybějícího údaje může vytvořit statisticky pravděpodobné pokračování. U čísel, jako jsou kredity, tokeny nebo měsíční kvóty, je takové domýšlení obzvlášť nebezpečné.
Komunita proto opakovaně doporučuje zapnout webové vyhledávání, omezit odpověď na oficiální stránky a vyžadovat citace. Někteří diskutující dávají přednost agentnímu režimu nebo specializované dovednosti, protože mají přístup k nástrojům pro práci s dokumentací. To je užitečná praxe, nikoli automatická záruka správnosti.
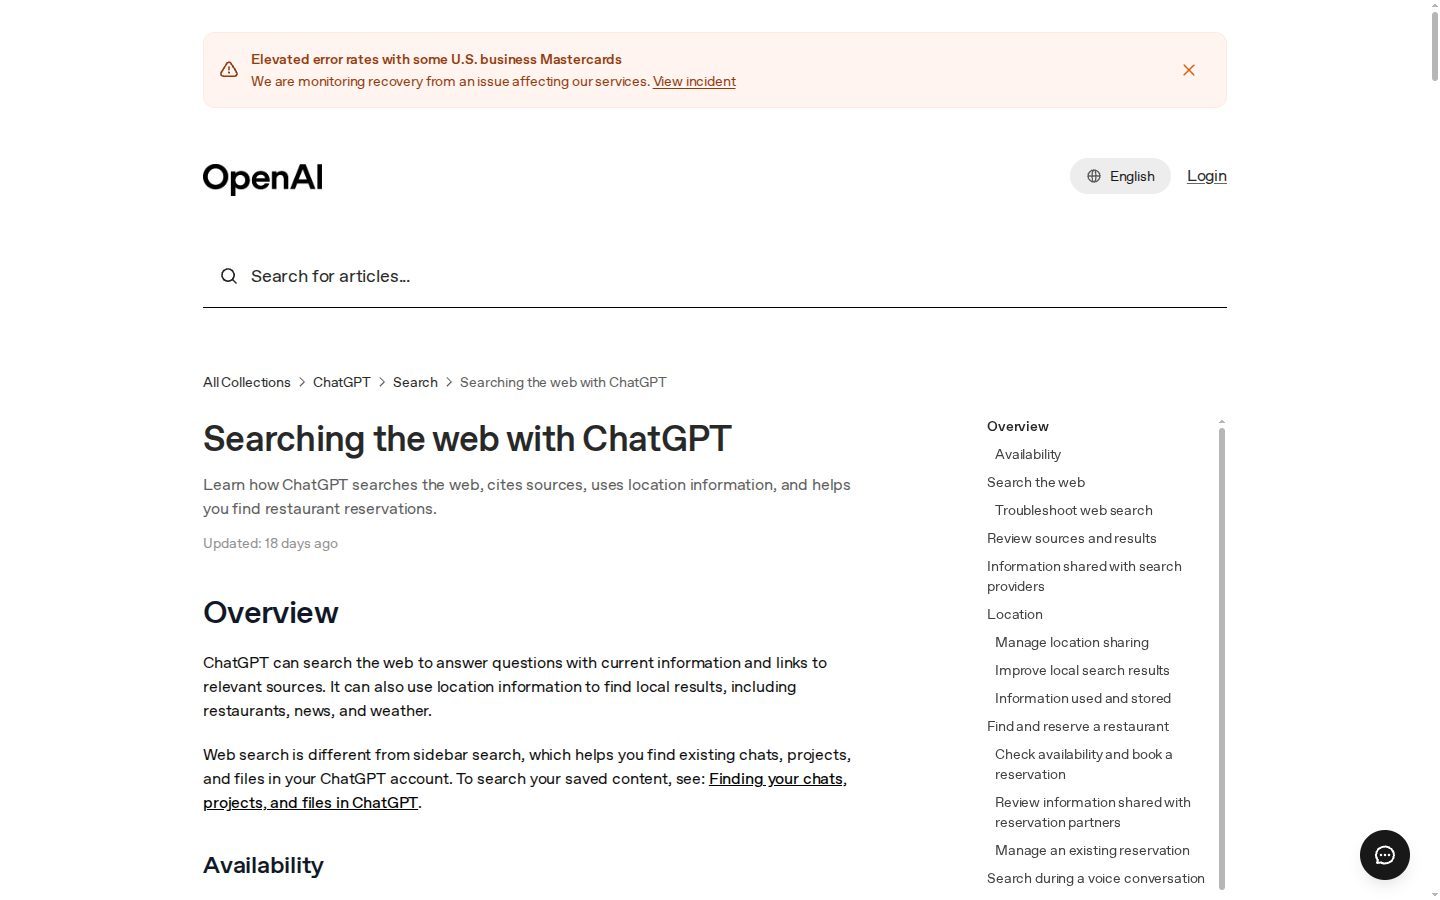
Co znamená „ověřit v dokumentaci“
Praktický postup lze přesněji označit jako retrieval-augmented workflow s restrikcí zdrojů a následnou kontrolou tvrzení. Model nejdřív získá text z vybraných dokumentů a teprve potom odpoví. U produktových otázek je zásadní doplnit dvě kontroly:
- Omezení domén. Povolit například
help.openai.com,developers.openai.comaopenai.com. Blogové články, fóra a neznámé stránky mají být doplňkový zdroj, ne základ tvrzení. - Kontrola každého čísla. Ceny, limity, kredity, verze a platnost je potřeba porovnat přímo s uvedeným odstavcem zdroje. Citace sama nestačí: model může odkázat na správnou stránku a přesto hodnotu domyslet nebo smíchat plány.
Samotná věta „použij aktuální oficiální dokumentaci“ proto nestačí. Užitečnější je vyžadovat strukturovaný výstup: tvrzení, hodnota, přesná citace, datum platnosti a případné omezení.
Použij pouze aktuální oficiální dokumentaci z těchto domén: [oficiální domény].
Odpověz na otázku: [produktová otázka].
Každou cenu, kvótu, pravidlo účtování kreditů, funkční limit a datum platnosti vyextrahuj do tabulky se sloupci: tvrzení, přesná hodnota, URL zdroje, citovaný úsek a datum zveřejnění nebo účinnosti.
Neodvozuj chybějící hodnoty. Označ každé nepodložené tvrzení jako NEOVĚŘENO.
Odděl veřejnou dokumentaci od informací, které lze potvrdit pouze v uživatelově účtu.
Jak to funguje pod kapotou a kde má postup limity
Vyhledávání se volí pravděpodobnostně, nikoli garantovaně. Model může odpovědět z paměti dříve, než nástroj spustí, nebo načíst zastaralý či protichůdný zdroj.
Ani po načtení dokumentace nejde o deterministickou extrakci. Model skládá odpověď z kontextu a může přehlédnout výjimku, zaměnit názvy plánů nebo doplnit chybějící číslo.
Veřejná dokumentace navíc nezná stav konkrétního účtu. Zbývající kredity, skutečně uplatněný limit, oprávnění administrátora i stav workspace patří do billingového či usage rozhraní nebo do dashboardu. Ani aktuální stránka nemusí být konzistentní s jinou oficiální stránkou, pokud jedna z nich zveřejní starší údaj.
Proto nelze spolehlivě tvrdit, že ChatGPT, Work, Codex nebo agentní režim mají privilegovaný kanál, který jim průběžně přidává veškerou aktuální dokumentaci vlastních produktů. Oficiální podklady popisují přístup přes vyhledávání, prohlížeč, nahrávané soubory či dokumentační MCP. Přesné kvóty vyhledávání ani mechanismus účtování přitom nejsou ve zprávě doloženy.
Další limit je samotná syntéza. Deep research, MCP, file search i webové vyhledávání stále vytvářejí odpověď modelem. Nejde o automatické porovnání výsledku se snapshotem dokumentace. Ověřování faktů pomocí AI proto potřebuje kontrolní krok navíc.
Který postup kdy použít
Pro běžnou otázku o ceně nebo funkci stačí v ChatGPT zapnout vyhledávání, omezit domény a vyžadovat přesné citace i datum platnosti. Je to rychlé, ale stále jde o odpověď se syntetizovanou odpovědí.
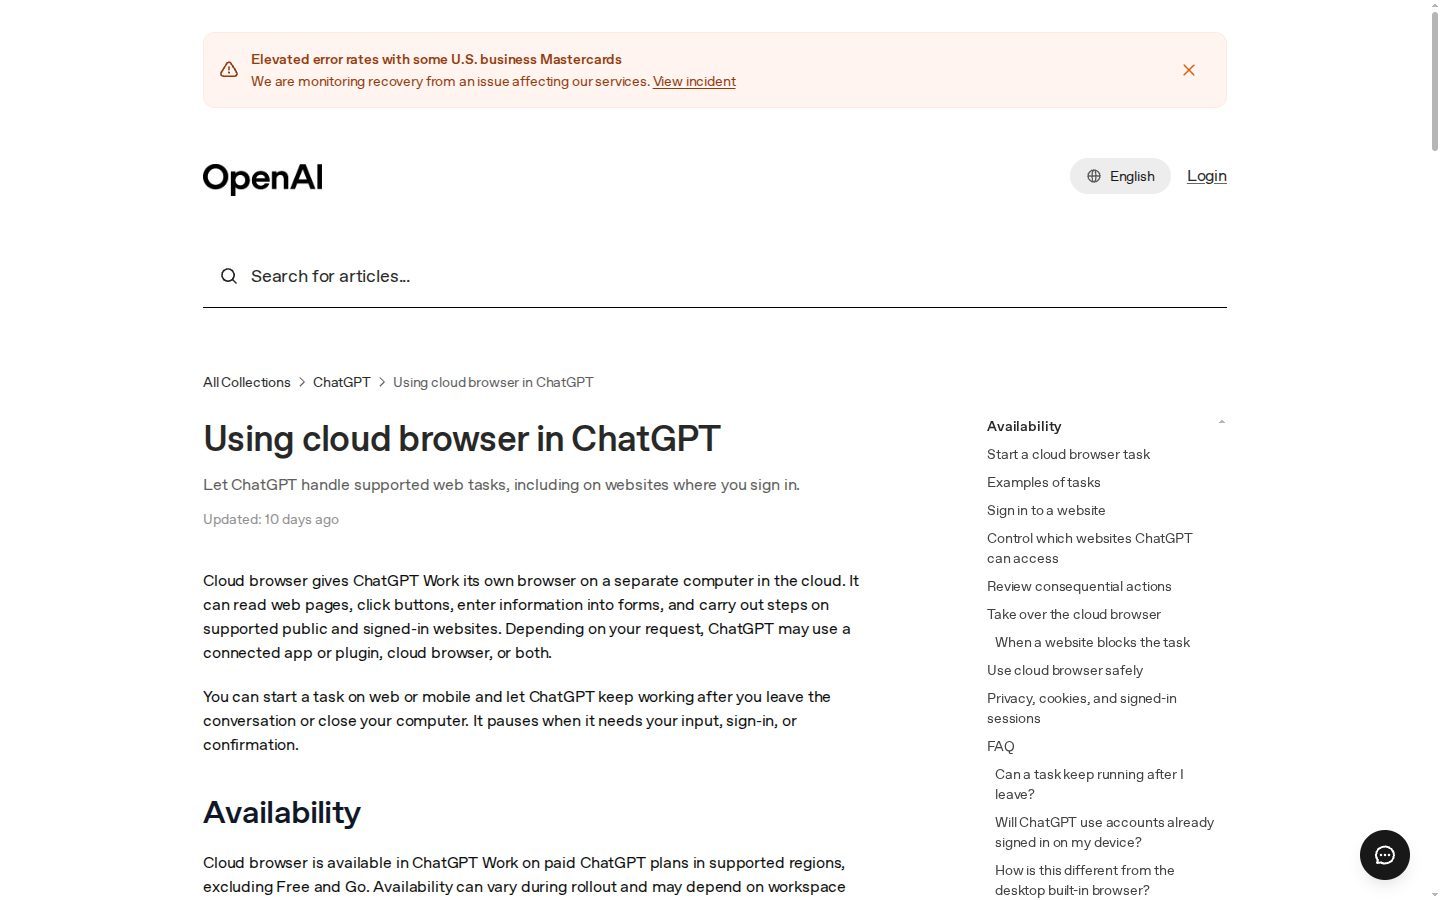
Codex je vhodný pro práci s vývojářskou dokumentací a pro projekty, kde lze uložit vlastní registry zdrojů nebo pravidla do AGENTS.md. Dokumentační MCP je užitečné pro vývojářské texty, ale nenahrazuje úplné informace o předplatném ChatGPT.
Pro rozsáhlý průzkum kombinujte více primárních zdrojů nebo vlastní snapshot stránek s evidovaným datem stažení. Snapshot umožňuje sledovat změny, ale musíte znát jeho datum a stále ověřit interpretaci jednotlivých údajů.
Praktický postup vypadá takto:
- Stáhněte dokumentaci.
- Vyextrahujte hodnoty do schématu.
- Nechte model formulovat odpověď.
- Zkontrolujte čísla a výjimky proti zdrojům.
AI agenti tak pomáhají s vyhledáním a kontrolou, ale neodstraňují potřebu ověřit čísla.
Veřejný help center je správný zdroj pro obecné chování produktu. Pro konkrétní účet použijte konkrétní billingový nebo usage zdroj. Pokud se obě informace liší, rozhoduje pro daný účet stav účtu, nikoli odpověď modelu.
Co si z toho vzít
- Vlastní produkty výrobce nejsou pro model automaticky aktuální znalostí.
- „Použij aktuální dokumentaci“ nahraďte whitelistem domén, přesnými citacemi a kontrolou čísel.
- Veřejná dokumentace a skutečný stav účtu jsou dvě různé kontroly.
- Citace dokládá odkazovaný zdroj, nikoli automaticky správnost interpretace.
- Pro vývojářské dotazy je užitečný Codex nebo dokumentační MCP; pro předplatné musí následovat kontrola cen a limitů v účtu.
- Užitečný je versionovaný vlastní index dokumentace s datem stažení a následná extrakce do struktury.