⚡ 61,2k tokenů · 5 modelů · Výpočetní stopa ▾
Které AI modely se na článku podílely a kolik tokenů spotřebovaly (vstup / výstup).
| Model | Role | Kde běží | Vstup | Výstup | Volání |
|---|---|---|---|---|---|
| MiniMax | plánování námětu | cloud | 12,3k | 440 | 1 |
| MiniMax | návrh článku | cloud | 9,1k | 2,1k | 1 |
| MiniMax | faktová oprava | cloud | 6,2k | 2,7k | 1 |
| MiniMax | ověření faktů | cloud | 5,3k | 704 | 2 |
| MiniMax | stylistika | cloud | 2,6k | 2,5k | 1 |
| Qwen 35B | audit přínosu | lokálně | 2,2k | 1,7k | 1 |
| gemini-flash (Antigravity) | jazyková korektura | cloud | 1,6k | 1,5k | 1 ~ |
| MiniMax | hodnocení přínosu | cloud | 2,9k | 139 | 1 |
| Qwen 35B | zpracování rešerše | lokálně | 2,2k | 764 | 1 |
| Gemma Vision | kontrola screenshotů | lokálně | 1,4k | 196 | 1 |
| perplexity (Grok 4.7) | audit přínosu | cloud | 248 | 1,3k | 1 ~ |
| perplexity (Grok 4.7) | ověření faktů | cloud | 134 | 940 | 1 ~ |
~ odhad: Perplexity a korektura Gemini běží mimo naši bránu, tokeny se odhadují z délky textu.
PDF na Markdown: kdy ušetříte tokeny a kdy převod přepíše dokument
Praktický návod, kdy převést PDF na Markdown před zpracováním AI, jak řešit skeny, tabulky a grafy a proč je potřeba výsledek vždy zkontrolovat.
Kdy převod PDF na Markdown dává smysl
Co uděláte, když AI zpracovává PDF se 45 stránkami, ale model dostane jen titulek a pár rozsypaných vět? Převod do Markdownu vám může ušetřit tokeny i práci. Jen záleží na tom, co PDF obsahuje. U digitálního dokumentu získáte čitelný text. U skenu, tabulek nebo vícesloupcového layoutu hrozí, že zformátovaný dokument nahradíte méně použitelným výstupem.
Převod PDF na Markdown není jen změna formátu. Jde o extrakci textové vrstvy a normalizaci dokumentu do podoby, kterou textový model zpracuje levněji než nativní PDF. Hodí se hlavně pro dokumenty s textovou vrstvou: smlouvy, výroční zprávy, příručky nebo články vytvořené digitálně.
V diskuzi se objevila 65,4% úspora vstupních tokenů na 45stránkovém dokumentu. Číslo ale nelze přenášet mezi službami: závisí na poskytovateli, tokenizeru i na tom, zda se počítaly také obrazové tokeny stránek. Jde o výsledek jednoho měření, ne o obecnou záruku.
Než začnete, odpovězte na tři otázky:
- Je PDF born-digital, tedy má textovou vrstvu, nebo jde o sken?
- Potřebujete pouze text, nebo také tabulky, grafy, vzorce a pořadí sloupců?
- Chcete do AI poslat celý dokument, nebo jen určité kapitoly?
U prosté prózy může stačit lokální extrakce textu. U dokumentů s tabulkami je nutné použít nástroj, který rozumí layoutu stránky. U skenu je bez OCR výsledek často jen titulek, záhlaví nebo prázdný výstup.
Jak to funguje pod kapotou a kde má postup limity
Když API přijme PDF, provider obvykle neposílá soubor samotný. K textové vrstvě přidává rasterizované stránky a vision tokenizer je rozdělí na dlaždice. Za každou stránku se tak účtují vizuální tokeny ještě předtím, než model začne číst obsah. V jednom z dostupných srovnání stály tři stránky v takovém režimu přibližně 7 000 tokenů proti 1 000 tokenům za čistý text. Rozdíl se liší podle providera, ale princip zůstává.
Převod do Markdownu tuhle položku odstraňuje. Výstup je však lineární text: ztrácí souřadnice, velikost písma, sloupce i vazby mezi tabulkou a její hlavičkou. Textová vrstva navíc může obsahovat nadbytečné mezery, absolutní pozice a špatně určené pořadí bloků. BPE tyto znaky počítá jako tokeny.
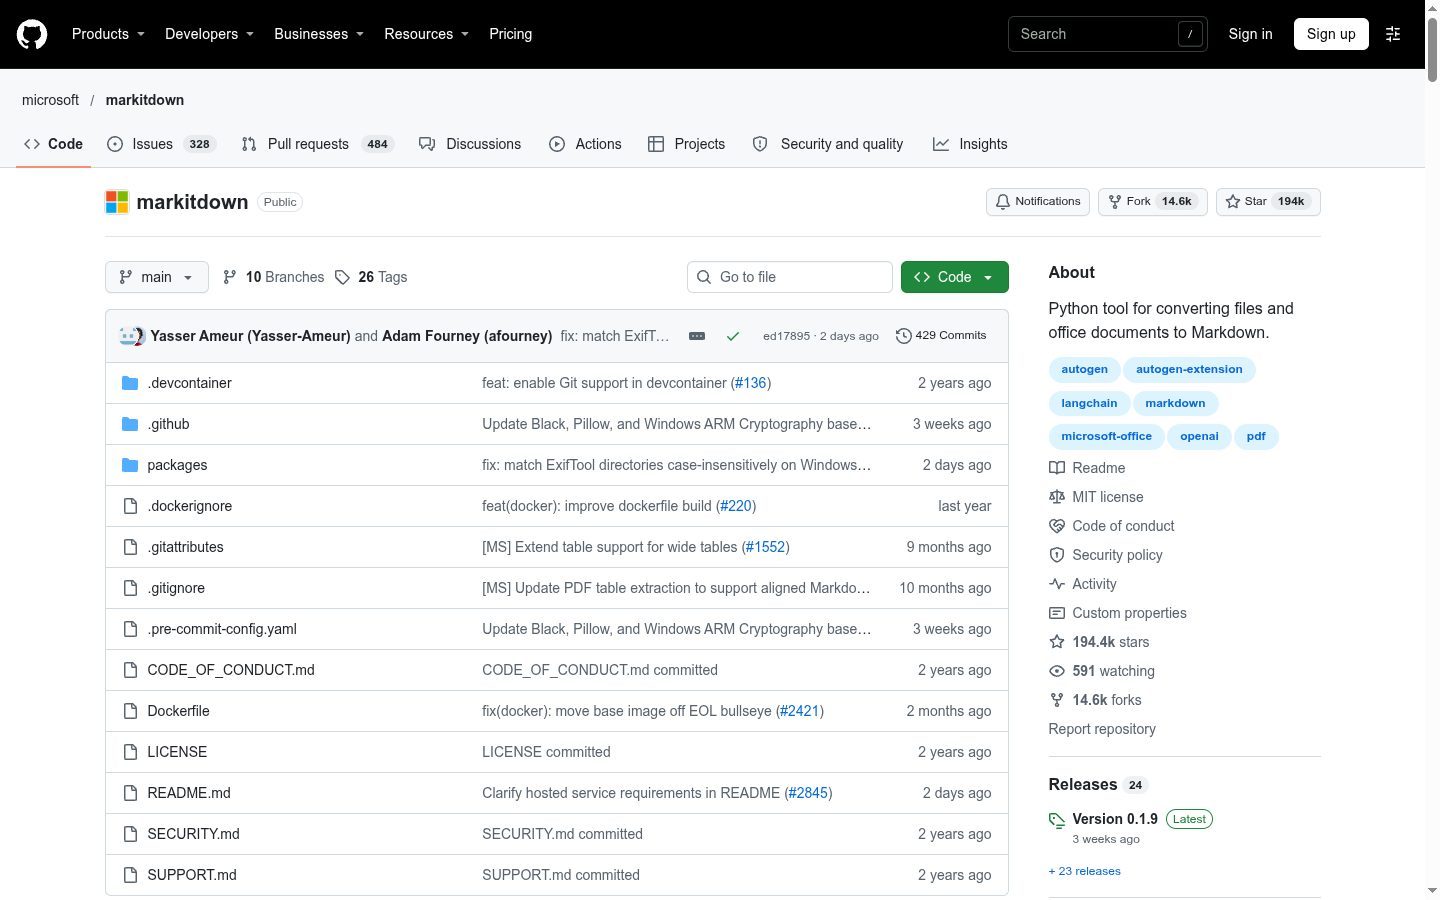
Druhý problém je tichá ztráta. Pokud sken obsahuje několik rozpoznatelných znaků, MarkItDown nemusí spustit full-page OCR, protože výstup není úplně prázdný. Výsledek pak působí jako „zpracovaný dokument“, ale obsahuje jen zlomky textu.
Tabulky, vícesloupcový layout a vzorce jsou přesně ty prvky, které jednoduchý lineární převod deformuje. Není proto bezpečné považovat Markdown za univerzální náhradu PDF.
Praktický postup pro pipeline
Nainstalujte nástroj přes pip install 'markitdown[all]'. Výstup získáte příkazem:
markitdown document.pdf > document.md
V reálné pipeline ale začněte klasifikací dokumentu:
- Kontrola textové vrstvy po stránkách. Nejde jen o to, zda PDF obsahuje nějaký text. Potřebujete zjistit, které stránky mají použitelný obsah a které jsou obrázkové.
- Volba parseru podle typu stránky. Pro prostý text stačí MarkItDown. Pro tabulky a vícesloupcový layout je vhodnější Docling nebo Marker. Pro technické PDF se vzorci, CJK textem nebo složitým layoutem se uvádí MinerU.
- OCR jen tam, kde text chybí. U skenů lze použít plugin
markitdown-ocr, který využívá multimodální model, nebo klasické OCR před převodem. Plugin je potřeba aktivovat přepínačem--use-plugins. Nasazení pluginu vyžaduje API a cloudové služby, takže u citlivých dokumentů je nutné zvážit lokální alternativy. - Chunking podle nadpisů. Neposílejte celý dokument. Rozdělte Markdown na kapitoly a odpovědi hledejte jen nad relevantními částmi.
- Kontrola výstupu. Porovnejte počet znaků, hledejte rozpadlé sloupce a prázdné stránky. U grafů, razítek a rukopisu použijte vizuální model na konkrétní stránku.
Časté chyby začínají už u prvního kroku. Nejjednodušší je převést celý soubor jedním příkazem a považovat tak vzniklý Markdown za hotový. Tím ale riskujete ztrátu layoutu, zbytečné zpracování a plné účtování tokenů i za stránky, které pro daný dotaz nepotřebujete.
Další pastí je spustit OCR nad celým dokumentem. Postup je pomalejší a může zbytečně odesílat data externí službě. OCR by mělo mířit pouze na skutečně potřebné stránky bez textové vrstvy.
Tato pipeline navíc odpovídá principu minimálního zpracování: systém by měl zpracovat jen dokumentaci, která je pro daný dotaz nezbytná, nikoli celý archiv. U skenovaných a interních dokumentů je navíc třeba vyhodnotit, zda data opustí organizaci.
Co v diskuzi reálně fungovalo
Cenné nebylo samotné slovo „Markdown“, ale několik konkrétních postupů. Detekce textové vrstvy po jednotlivých stránkách zabrání zbytečnému OCR. Výběr jen relevantních částí z rozsáhlého manuálu šetří víc než důkladný převod celého souboru. U dokumentů s obrázky se ukázalo jako praktické ponechat vedle Markdownu multimodální zpracování původních stránek.
Označení „nejlevnější způsob“ je zavádějící. MarkItDown je rychlý nástroj pro základní extrakci, nikoli plnohodnotný parser pro RAG. Jeho výstup je vhodný pro full-text vyhledávání, sumarizaci prostého textu a předřazení před kontext modelu. Pro tabulkovou strukturu nebo přesnou layoutovou hierarchii je nutné zvolit jiný nástroj.
Co si z toho vzít
- Převod PDF na Markdown je extrakce a normalizace textu, ne bezproblémová náhrada vizuálního dokumentu.
- Nejprve určete typ dokumentu: born-digital, sken, tabulky nebo vzorce. Teprve potom zvolte parser.
- MarkItDown je vhodný pro rychlou prvotní extrakci; Docling, Marker a MinerU řeší složitější dokumenty lépe, ale pomaleji.
- OCR aplikujte pouze na stránky bez textové vrstvy. U skenů kontrolujte výstup, protože částečný text může maskovat chybějící OCR.
- Největší úsporu přináší odesílání jen relevantních částí dokumentu, nikoli samotný převod formátu.
- Ceny tokenů ověřujte na vlastní dokumentaci: poskytovatel, tokenizer a započítání obrazových tokenů výsledek výrazně mění.